1860 年八里橋,三萬清軍對八千英法聯軍。四小時後清軍陣亡逾一千二百人,聯軍陣亡五人 。
不是清兵不夠勤力。而是從那一天起,勤力不再是勝負的變數。
武器才是。
這篇不談價值投資有多落後,而是一步一步,把屬於你的科學電磁砲組裝出來。
第一步:把一句永遠不會錯的話,拆成一句可以被殺死的話
價值投資者:「我看好,因為這家公司會轉型為平台,市場都低估了他的內在價值。」
股價上漲,是市場開始理解。股價下跌,是市場尚未理解。無論發生什麼,這句話都能繼續成立。
科學哲學稱這種陳述為不可證偽(unfalsifiable):不能被任何證據推翻的說法,不是科學 。多數投資論點都停在這一層,所以看錯之後無從歸因,只能重新編一個故事。
第一個動作,是把論點拆到可以被殺死為止。
最上層是論點本身。往下三到五條分支,每一條都是論點成立的必要條件——不是加分項,而是缺了就不成立。每條分支再拆成幾片葉,每一片寫明證據來源與證偽門檻,例如「若連續兩季設計中標少於 N 件,此葉即證偽」。
                  ┌──────────────────────────┐
                  │ H0:這家公司會轉型為平台     │   ← 論點
                  └────────────┬─────────────┘
                               │
          ┌────────────────────┼────────────────────┐
          │                    │                    │
    ┌─────┴─────┐        ┌─────┴─────┐        ┌─────┴─────┐
    │  分支 A    │        │  分支 B   │         │  分支 C   │   ← 必要條件
    │ 客戶黏著   │         │ 毛利結構  │          │ 生態夥伴  │
    └─────┬─────┘        └─────┬─────┘        └─────┬─────┘
          │                    │                    │
      ┌───┼───┐            ┌───┴───┐            ┌───┴───┐
      葉  葉  葉            葉     葉            葉       葉      ← 可獨立死亡的位置

           每片葉:證據來源 + 證偽門檻
一句話至此變成一棵樹。看錯的時候,你第一次知道是哪一片葉錯了。
第二步:把「這個風險很關鍵」改寫成一個數字
任何人都能說某條風險很關鍵。但關鍵到什麼程度?跌 5% 算關鍵,還是跌 40% 才算?
如果一條「關鍵風險」兌現之後股價毫無反應,它從一開始就不關鍵。這是所有主觀分析的死穴:形容詞無法對答案。
所以每一條分支都要標上衝擊等級,共五級,各自對應一個預設權重 :
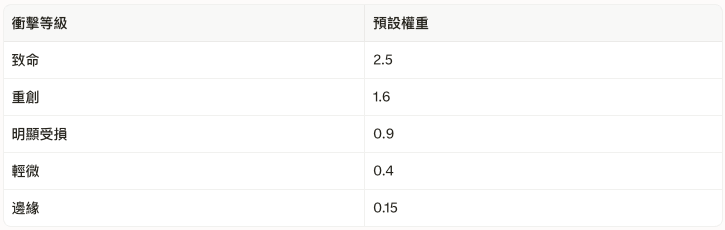
等級不只是排名。它回答一個非常具體的問題:如果這條分支被推翻,整體信念應該跌到哪裡?寫樹的人必須先給出等級,系統再換算成上表的權重 。
借自 1960 年代美國為飛彈與核電系統發展的故障樹分析(Fault Tree Analysis):一個零件重不重要,不在於它昂貴與否,而在於它斷掉之後整台機器會不會垮 。
                  ┌──────────────────────────┐
                  │   H0    目前信念 0.62     │
                  └────────────┬─────────────┘
                               │
          ┌────────────────────┼────────────────────┐
          │                    │                    │
    ┌─────┴─────┐        ┌─────┴─────┐        ┌─────┴─────┐
    │  分支 A    │        │  分支 B   │        │  分支 C    │
    │   重創     │        │ 明顯受損   │        │   邊緣     │   ← 衝擊等級
    │   1.6     │        │   0.9     │        │   0.15    │   ← 換算權重
    └─────┬─────┘        └───────────┘        └───────────┘
          │
          ↓ 若被推翻
    承諾:整體信念跌至 0.22
寫下等級的那一刻,你同時寫下了一個能被市場股價檢驗的承諾。從「我覺得這很重要」,變成「如果我錯了,你可以拿這個數字來質問我」。
第三步:讓機器每週自己去讀那些葉
樹畫好了,但沒有人有時間每週手動檢查超過一千片葉 。
這一步是整套系統需要「工程」的地方。而它的演化路徑,剛好就是這兩年 AI engineering 走過的路:prompt → loop → graph。
第一層:Prompt Engineering
你對 AI 的問法可能是這樣的:
「幫我分析一下這家公司的競爭優勢還在不在。」
回來的東西很漂亮:三段論述、幾個數字、一句「整體而言仍具韌性」。問題是它不能對答案——下週再問一次,可能得出相反結論,而你無法指出中間哪裡變了 。
畫樹投資者則是這樣做:
「這是分支 B 底下的葉 3。定義:連續兩季設計中標(Design Win)少於 N 件即證偽。這是過去七日的證據清單。請只輸出六個判定值的其中一個,並附上引用來源。」
三處關鍵改動:
問題被綁死在一片葉上,不是整家公司
證偽門檻寫在題目裡,不由模型自己決定什麼叫「還在」
輸出格式收窄成六選一,不是自由發揮(✅/🟢/⚪/🟡/🟠/🔴)
模型的角色從「分析師」降格為「判卷員」。它不再負責思考公司好不好,只負責回答一條有標準答案的選擇題。
第二層:Loop Engineering
單次判讀再準也沒用,因為證據每天都在變。第二層決定這台機器什麼時候開工、做什麼、何時算完成 。畫樹投資者的迴圈長這樣:
觸發:每週固定掃描一次,另加財報公布翌日的專門重審,兩種觸發分開標記
取證:逐片葉搜尋新資料,模型自行決定要查幾次、查什麼
判讀:每片葉更新為六個判定值的其中一個
落賬:每一次改動寫入紀錄,記下哪棵樹、哪條分支、由什麼變成什麼、由什麼觸發、當時用的是哪一個模型
第三層:Graph Engineering
到這裡還是一條直線:取證 → 判讀 → 落賬。但一片葉翻了,整棵樹的信念該怎麼變?
第三層把流程從一條直線改寫成一張圖。關鍵在於,圖上的節點不一定都是 AI:有些是確定性函數、路由器、工具呼叫 。
這正是「樹」在這套系統裡的真正身分。它不是一張思維導圖,它是引擎的執行圖:
葉節點由 AI 判讀,這是唯一容許主觀的地方
分支節點是純數學:把底下的葉按第二步那五個權重合成,不容模型插手
根節點同樣是公式,把各分支結果匯總成整體信念
路由節點負責分流,例如財報觸發的判讀走另一條計分路徑
┌──────────────────────── 每 週 迴 圈 ────────────────────────┐
│                                                             │
│   觸發 ──→ 逐葉取證 ──→ 模型判讀(六選一)                       │
│    ↑                          │                             │
│    │                          ↓                             │
│    │                  分支合成(純公式)                       │
│    │                          │                             │
│    │                          ↓                             │
│    │                     根信念更新                           │
│    │                          │                             │
│    └────── 落賬(不可刪改・戳上模型印記)←───────────────────────┘
│                                                             │
└─────────────────────────────────────────────────────────────┘

     AI 只負責「六選一」那一步,其餘全部是確定性節點
這張圖最大的價值,是把 AI 關進籠子。
模型只能改變一片葉的判定值,不能決定那片葉有多重要,不能決定它怎麼影響整棵樹,更不能改寫證偽門檻。它答錯了,錯誤只會沿著預先寫好的路徑傳播,而且沿路留下紀錄。
三個月後回頭看,不需要靠記憶。所有錯誤能夠被事後檢驗(Post-mortem)。
第四步:量度負責判讀的 AI
如果連工具本身壞掉了,你要虧多少錢才會發現?
多數人是靠虧錢發現的,而且分不清究竟是市場出了問題,還是方法出了錯。
畫樹者可以用數據回答一條多數人答不出的問題:是零件壞了,還是市場真的變了?
今年 7 月中,我們那個迴圈的判定轉變量突然暴增到平時的四到六倍,方向明顯偏空 。
換作是人,這時候多半會開始解釋:也許市場真的轉壞了。
我們的處理方式是凍結證據做 A/B 測試:把同一批輸入交給兩個模型,各跑三次,看誰穩定 。
結果新換的那個模型,面對完全相同的證據,可以判出橫跨三個等級的不同答案,無故改判五次裡有四次向下 。推算它每週製造約 28 個純噪音轉變,與實際觀察到的 32 個吻合 。
模型當天換掉,受影響三天內的所有轉變整批重審、更正入帳 。
                    同一批凍結證據
                          │
              ┌───────────┴───────────┐
              ↓                       ↓
        ┌───────────┐           ┌───────────┐
        │  模型 A    │ × 3       │  模型 B    │ × 3
        └─────┬─────┘           └─────┬─────┘
              │                       │
        一致性 100%              一致性 95%
        零次失敗                 五次無故改判
                                 其中四次向下
              │                       │
              └───────── 當天換掉 ─────┘
那一週的「市場轉壞」,其實是改卷老師換了人。
第五步:把判定變化,變成一個可以下注的部位
到這裡為止,這台機器每週產出的只是一堆判定變化。它們還不是錢。
要變成錢,需要先寫下一句能夠被證明是錯的話——主假說(Hypothesis)。
樹的判定變化,走在股價前面。降級的股票其後一週跑輸全池中位,升級的跑贏;等級越重、降級越齊,效應越強 。
這句話同樣符合第一步的標準:它可以被殺死。只要降級組其後跑贏,這句話就錯了。
由此推出的策略非常直接:做多升級組,做空降級組 。
                    每週判定掃描
                          │
              ┌───────────┴───────────┐
              ↓                       ↓
          升級的股票               降級的股票
              │                       │
            做 多                   做 空
              │                       │
              └───────────┬───────────┘
                          ↓
策略回報 = 升級籃超額 - 降級籃超額這樣做有一個關鍵好處:大盤漲跌與產業順逆風,在兩邊互相抵銷 。
如果只做多,賺了錢也不知道是自己判斷準,還是大盤剛好在漲。一多一空之後,剩下的才是這套判斷方法創造的價值。
策略回報序列持續大於零,這套系統才算有 alpha(超額報酬) 。
單邊也照樣計分。某一週只有降級沒有升級,就做空那一籃、用全池對沖。
第六步:讓成績表回頭校準這台機器的參數
長槍與電磁砲的最大差別:後者能夠被真實數據反饋、校準、自我進化。
要看清這一步在校準什麼,先回到上一步留下的一個未解問題。
策略是做多純升級組、做空純降級組。但同一籃裡的五檔股票,該不該押一樣多?
不該。有些股票是「致命」級分支翻掉,有些只是「邊緣」級微調——把它們押成一樣,等於把最強的訊號稀釋掉。所以每個部位的份量,由訊號分決定:當週所有判定變化,按第二步那五個權重加總,升級為正、降級為負 。等級越重的變動,佔的份量越大。
於是這條策略最關鍵的參數,就是那五個權重本身。
它們決定了資金怎麼分配。權重錯了,不是判斷錯,而是押錯份量——看對了方向,卻在最強的訊號上押得太輕。
所以系統每週同時記錄兩套成績:等權版與訊號加權版。前者是對照組,後者是真實策略。加權版長期贏不了等權版,就代表那五個權重要被改寫。
這種比對,同時發生在機器身上的五個位置。
等級權重的數值。 2.5、1.6、0.9、0.4、0.15 只是『專家』寫下的起始值。某一級累積滿 30 個獨立樣本,就用實際股價反應算出的實證值,與原本的猜測混合,得出新的權重 。權重一改,下週的下注份量隨即改變。
每支股票的個別評分。 光有等級不夠。同樣標成「重創」,A 公司的供應鏈風險和 B 公司的監管風險,市場反應未必相同,有可能『專家』的起始值標錯了。所以還有第二層:每條分支的歷史表現先向所屬等級的平均值收縮,再向全體平均收縮 。這一層門檻是 10 個樣本 。三兩次的異常,不會被誤當成發現。
持股期。 起始設定是一週。但校準追蹤的是第 1 到第 8 週的完整曲線,曲線在第幾週見頂,那一週就是最佳持股期 。
樹的保鮮期。 分支與證偽條件都寫於建樹那一刻。時間過去,論點的解釋力可能衰減,也可能因為經過篩選而更準。方向不預設,登記為雙尾檢定,交由數據決定 。一旦成立,訊號分會乘上一個隨樹齡遞減的折扣因子 。
訊號來源的分層。 每週例行掃描發現的新資訊,與財報公布翌日的重審,性質完全不同——後者的股價早在公布當下就反應了大半 。兩層永遠分開計分,各自累積、各自校準 。
              每週策略成績(等權 vs 訊號加權)
                          │
      ┌─────────┬─────────┼─────────┬─────────┐
      ↓         ↓         ↓         ↓         ↓
  ┌───────┐ ┌───────┐ ┌───────┐ ┌───────┐ ┌───────┐
  │ 等級   │ │ 分支   ││ 持股   │ │ 樹的   │ │ 訊號   │
  │ 權重   │ │ 評分   ││ 期間   │ │ 保鮮   │ │ 分層   │
  └───┬───┘ └───┬───┘ └───┬───┘ └───┬───┘ └───┬───┘
   30 樣本   10 樣本   8 週曲線   雙尾檢定     分層計分
      │         │         │         │         │
      └─────────┴─────────┴─────────┴─────────┘
                          ↓
改寫下週的下注份量這五項校準的共同名字是:貝葉斯更新(Bayesian updating)。
每一個參數的起始值都是先驗(prior),動工之前寫下的最佳猜測。判定轉變連同其後的股價是似然(likelihood),世界對這個猜測的回應。兩者結合成後驗(posterior):獲得數據支持的保留,被反駁的向實證收縮 。
這台機器身上沒有常數,只有變數。它們今天的值,只是等著被下一批數據校準。
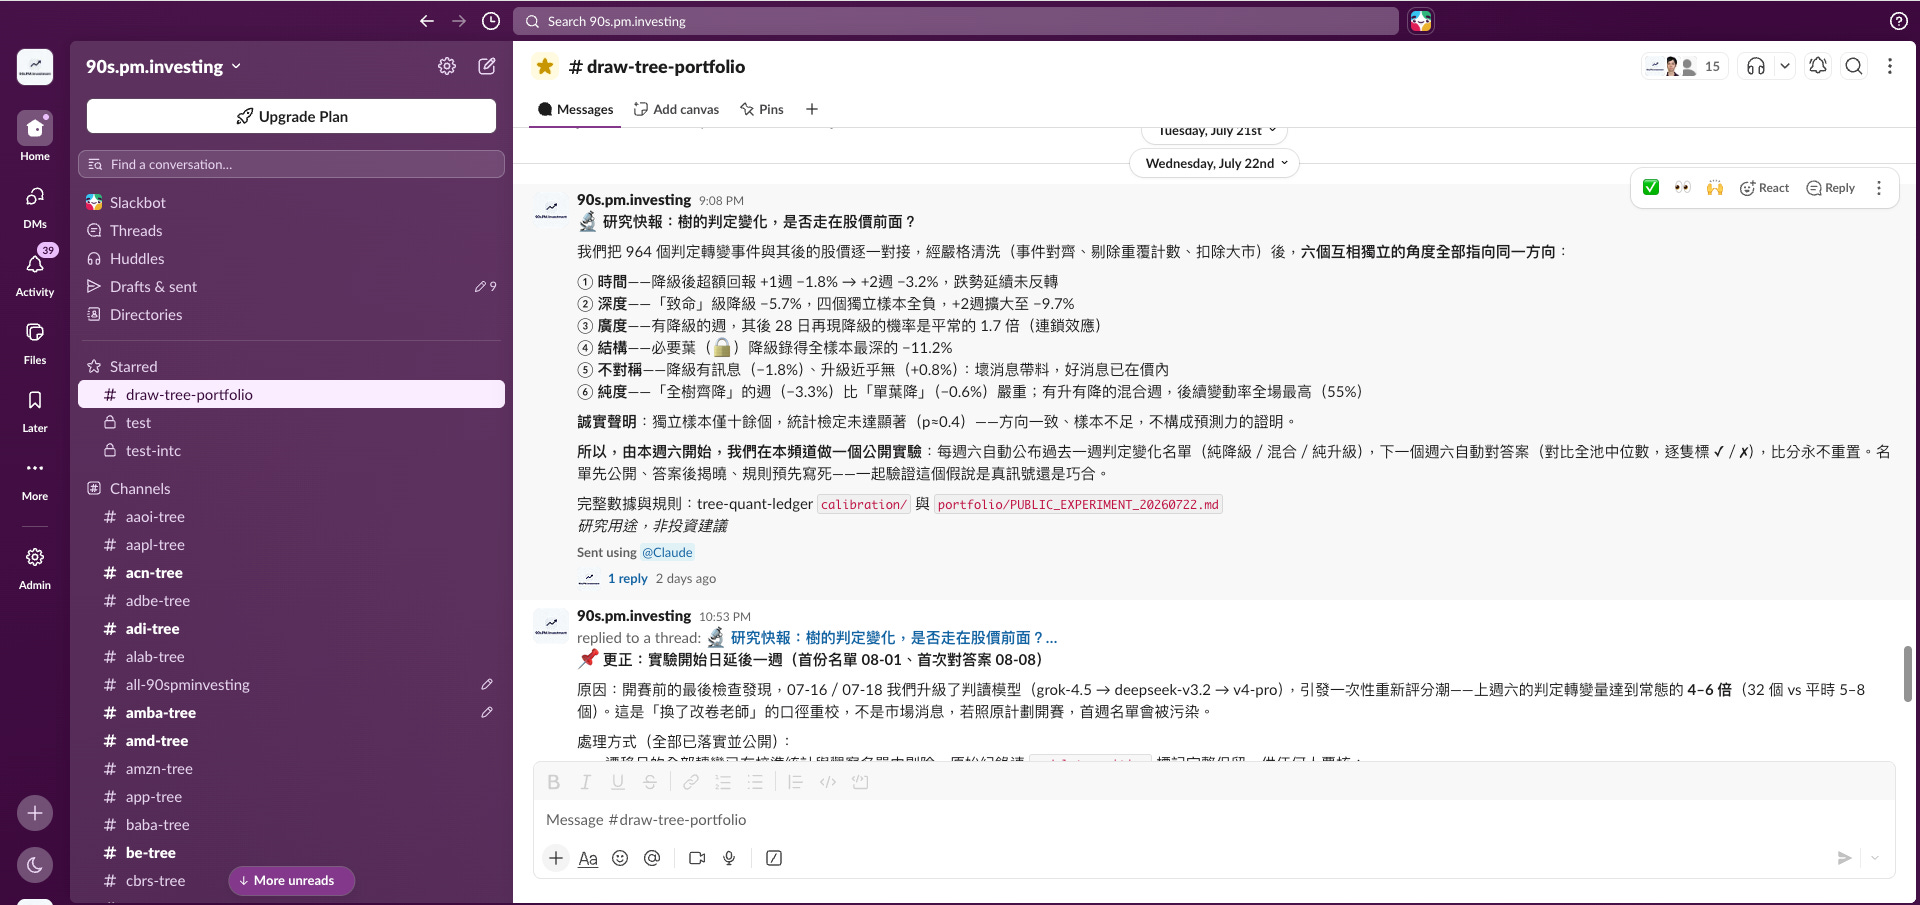
六個步驟裝完之後,上週的讀數
規則是每週日先公布名單,下週日才對答案 。帳本只能追加,不能刪改 。
🎯 核心讀數:策略回報(等權)+11.2pp|(訊號加權)+6.2pp
升級籃超額 +11.6pp、降級籃超額 +0.3pp;買入側命中 7/7、沽空側命中 7/15。
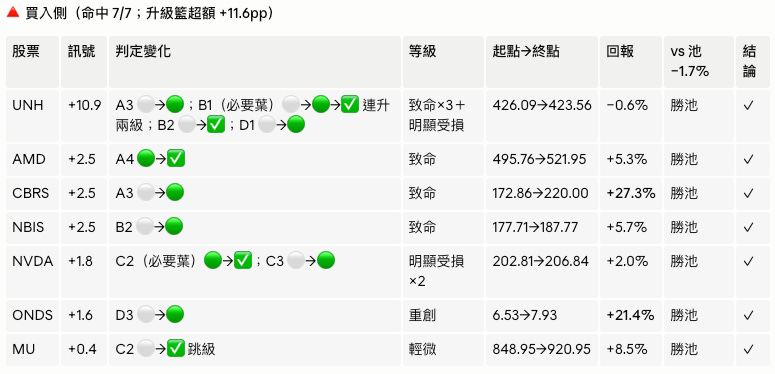
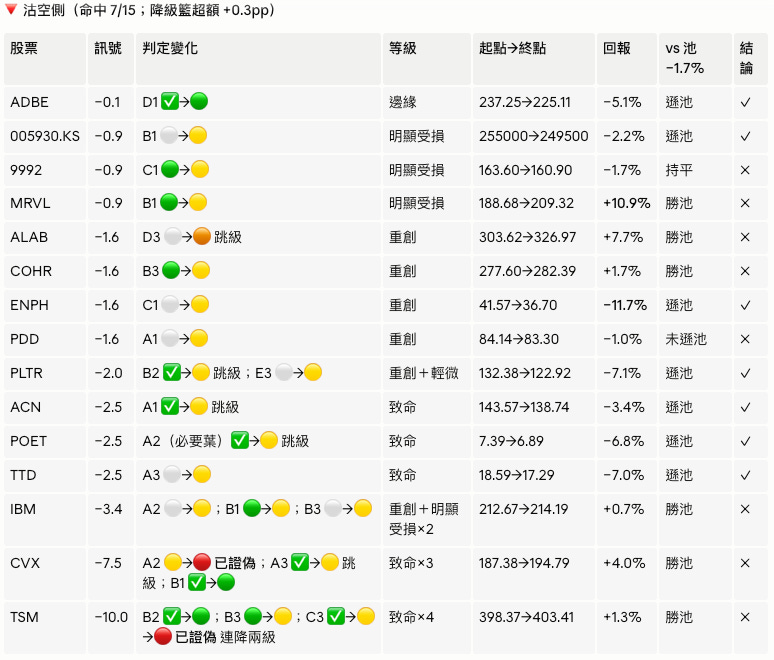
完整紀錄每週更新:github.com/Draw-Tree/tree-quant-ledger
這是一個公開實驗,並非投資建議。讀者據此決策需自負風險。
換一件武器,不需要工程團隊,只需要一頁紙
八里橋之後,清廷的結論是要多練兵。
問題不在練得夠不夠。手上那件東西沒有讀數,練一百年也只是把同一把槍磨得更利。在科學面前毫無還擊之力。
上面六個步驟,其實可以壓縮成一頁紙。在下一次按下買入之前,寫下三件事:
這一次的假設是什麼,用一句帶方向的話寫出來
什麼證據出現,會證明這個假設是錯的
打算多久之後回來檢查
三個月後打開它。你會看到的不只是賺賠,而是當時的推理——哪一步站得住,哪一步只是情緒。那一刻,第六步自動裝上:你手上的東西第一次會自己變準。
72 棵樹、910 片葉、A/B Testing、Bayesian updating,本質上都只是這一頁紙的放大版 。技術決定它跑得多快,方向由第一頁決定。
跨過這條線,改變的不是持股,而是認知。
從一個憑感覺開槍的士兵,變成一個看著讀數調整整條戰線的統帥。前者靠故事支撐,一把槍磨一輩子;後者手上是一件件會自我診斷、逐週校準、自我進化、二十四小時無休的科學電磁砲。
多數人終其一生停在前者。不是做不到,而是從來沒有人告訴他們,投資可以是一場能被驗證的實驗,而不只是一場需要不斷解釋的表演。
現在你知道了。第一個零件,今晚就可以裝上。
本文僅供研究與討論,不構成投資建議。讀者據此決策需自負風險。
會員專區 - 加入 Slack、共建畫樹者的科學電磁炮