把導彈工程師、保險精算師、貝爾實驗室物理學家、高盛量化團隊、諾貝爾經濟學家各自解過的問題,接成一條流水線——因為這些問題,本質上是同一個問題。
起因
本週,系統在對一隻股票信念只有 0.58 的情況下,把 10.8% 的倉配進去。
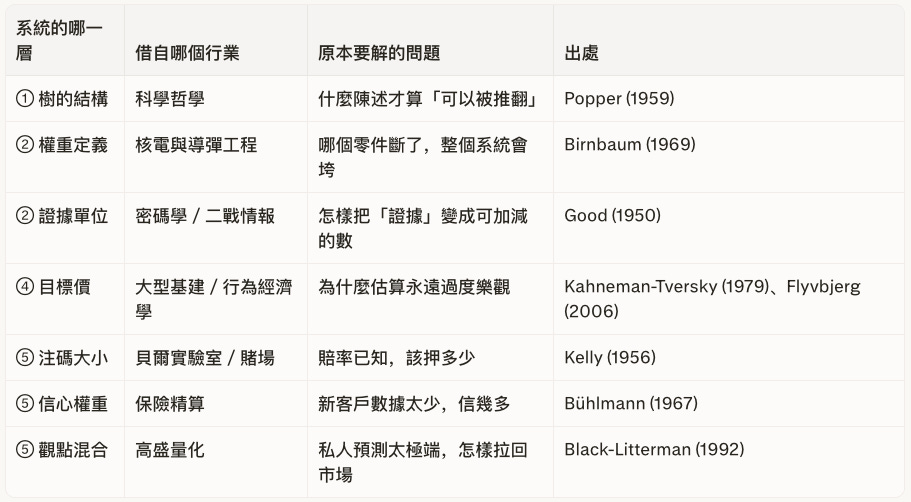
追查到底,三個部件各有一個缺陷,剛好疊在同一隻股票(AMBA)上。修的過程中我發現一件事:每一次卡住,答案都不在金融教科書裡,而在在幾十年前就被逼着解過同一道題的各行行業。
「早就付過學費」的行業
第一步:向科學哲學借「可證偽性」
「這家公司會轉型為平台」——這句話無法被檢驗,所以它不能直接進入系統。
Karl Popper(1959)在《科學發現的邏輯》裡立下一條界線:一個陳述若不能被任何證據推翻,它就不是科學。這套系統把同一條界線搬進投資——一個論點必須先被拆成可以被具體數字、具體期限推翻的子假說,才有資格進樹。
根節點(H0)是論點本身;三至五條分支,每條是論點成立的必要條件;每條分支再拆成幾片葉,每片寫明證據來源與證偽門檻(例如「若連續兩季設計中標少於 N 件,此葉證偽」)。
每週自動管道逐葉搜尋新證據,標為六值判定之一:
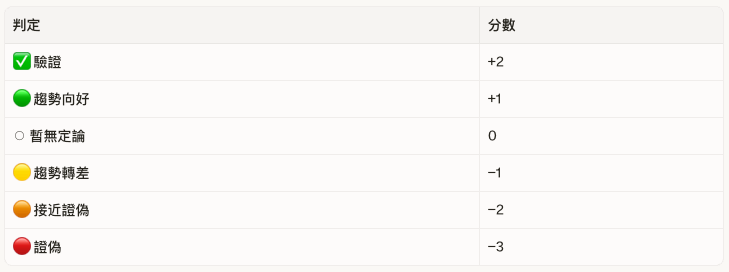
分數尺刻意不對稱:底是 −3,頂只有 +2。推翻比支持有力——這個 Popper 式的偏見,會從第一步一直貫穿到最後。
第二步:向核電工程借「哪個零件斷了,系統會垮」
舊制的問題不在排名,在沒有可核對的定義。
舊制按重要性排名,套 Fibonacci 數列(8/5/3/2/1)。但排名回答不了權重存在的唯一目的:「這條分支被推翻,整體信念應該跌到哪裡」。
答案來自一個意想不到的地方。一九六〇年代,美國為了導彈與核電系統的可靠性,發展出 Fault Tree Analysis(故障樹分析)——把「系統失效」與各零件失效畫成一棵樹。Birnbaum(1969)給出定義:一個零件的重要度,等於系統失效機率對該零件失效機率的敏感度。換句話說,重要的不是零件貴不貴,而是它斷了、整台機垮不垮。
本系統的研究樹在結構上就是一棵故障樹(結論是根、分支是零件),定義直接套用。而衡量的單位,又借自另一個行業——
向密碼學借「證據的重量」。I. J. Good(1950)——二戰時在 Bletchley Park 與 Turing 一起破解 Enigma 的統計學家——提出用對數勝算(logit)作為「證據重量(weight of evidence)」的單位:
機率 0.5 對應 0,愈確定為真愈大、愈確定為假愈負。好處只有一個,但關鍵:證據可以直接相加減。
建樹時每條分支回答「若被證偽,整體信念應跌到哪裡」,權重由答案換算:
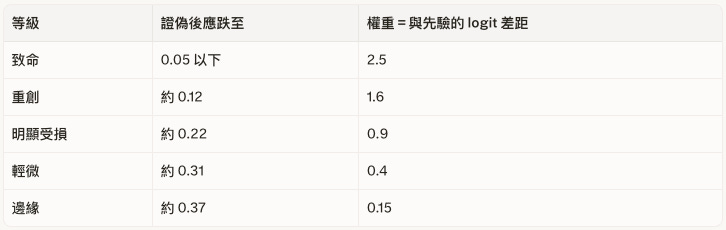
換算示範(重創級):logit(0.12) = −1.99,logit(0.40) = −0.41,差距 1.58,取 1.6。舊 Fibonacci 權重歸一化後與此表前三級接近(1 : 0.63 : 0.38 對 1 : 0.64 : 0.34)——原本的排名直覺方向沒錯,缺的是可核對的定義。尚未遷移的舊樹,引擎按對照表換算(8→致命、5→重創、3→明顯受損、2→輕微、1→邊緣)——Fibonacci 數值不是 logit 單位,不得直接相加。首批 17 棵樹已按此重評,70 條分支中 46 條與機械換算不同——最一致的發現:舊排名把「不容易翻轉」與「翻轉了也不要緊」混為一談。
第三步:把「平均」改成「相加」——讓證據像故障樹一樣累積
「平均」這個運算,本身不容許小權重分支造成大跌。
對 72 棵樹運行 flip-test(逐條分支模擬全部子假說證偽),144 個承諾達不到。以 V 為例:一條「重創」分支只佔總權重 3/11,其餘 8/11 停在高位,平均後整體只跌到 0.62,而承諾是 0.22。
既然第二步已經借了故障樹的 logit 單位,第三步就順理成章讓證據像故障樹的失效機率一樣相加,而不是平均:
上行折減(×0.5)的理由:分支成立只代表論點少了一種死法,不代表論點已被證明——必要不等於充分,所以驗證只記一半。
三個驗算:
零證據:logit = −0.41,信念 = 0.40,起點不變
單一「重創」分支證偽:c=1.6×(−3÷3)=−1.6c = 1.6 \times (-3 \div 3) = -1.6c=1.6×(−3÷3)=−1.6;logit = −2.01;信念 = 0.119 ≈ 承諾的 0.12
累積:三條「明顯受損」全部驗證,c=+0.9c = +0.9c=+0.9,信念 0.621——高於一條驗證的 0.474,平均制做不到
第一步的分數尺(−3 對 +2)與本步的折減(×0.5)疊加,證偽與驗證的力度比為 3:1——「大膽假設,嚴格求證」寫進了公式本身。
重跑 flip-test:144 個偏離全部消除。全艦隊 72 棵重算:平均信念 0.619 → 0.496,標準差 0.176 → 0.121。
第四步:向行為經濟學借「你的估算一定過度樂觀」
AMBA 事故的估值錯誤只有一句話:熊市目標 $63.73 高於當時股價 $61.84。
模型宣稱這隻股票沒有下行。根源在對照組:熊市側被兩隻正處災難期的名義同業(MBLY、CRNC)拖低。
修正方法來自兩位諾貝爾級的名字。Kahneman 與 Tversky(1979)發現:人從個案細節向外推演時,系統性地過度樂觀——這叫 inside view。修正方法叫 reference class forecasting(參照組預測):先看歷史上同類個案的實際結果分佈。Bent Flyvbjerg(2006)把它應用到大型基建預算審核(那些永遠超支的隧道與橋樑),其後被英國財政部正式納入指引。
搬過來的規則:情境描述的不是今天,而是「另一個狀態」。熊市對照的,應該是歷史上真正到過那個谷底的公司,在那個時刻市場實際付過的價格。
AMBA 熊市重算:案例取 AMBA 自己 2018 年的需求斷崖(GoPro 訂單消失),谷底 4.69 倍營收(Macrotrends;Motley Fool 當年獨立記載約「六倍營收」,兩源一致);扣除大額淨現金後約 3.5 倍企業價值對營收。
一個真實出現過、低於現價的水平,取代原本高於現價的 $63.73。牛市同理:AXON 2019–21 被承認為平台時期的持續中位約 12.7 倍 → 換算今日約 10.8 倍前向,目標 $118.3(原 $141.07)。原型案例庫已建成 14 個歷史情節(八個牛市承認期、六個熊市谷底)。
第五步:向貝爾實驗室、精算、高盛借「該押多少」
Kelly 公式沒有錯。是兩個輸入異口同聲說「這注不會輸」,公式理性地回答「那就全押」。
向貝爾實驗室借注碼公式。John Kelly(1956)——貝爾實驗室物理學家——為「勝率與賠率已知的賭局」證明了令長期資本增長最快的注碼比例:
p = 勝率,q=1−p,b = 贏幅,a = 輸幅。分子是期望回報;分母是賠率乘積——當輸幅 a 趨近零時,分母趨近零,注碼趨近無限大。這一點是事故的伏筆。
三情境各自的角色:
牛市提供贏幅:
\(b=(牛市價−現價)÷現價\)熊市提供輸幅
\(a=(現價−熊市價)÷現價\)基準折入有效勝率:
\(p_{\text{eff}} = (ER + a) \div (a + b)\)
AMBA 事故重演(事發當日:現價 $61.84;目標 牛 $141.07/基 $95.92/熊 $63.73):機率層讓熊市機率=0(牛 0.34/基 0.66/熊 0);估值層讓輸幅 a≤0a \leq 0a≤0。兩個缺陷送入公式,f∗f^*f∗ 發散至原始值 5.68,經上限與歸一化後仍配得 10.8%。
修正需要一個「證據不足時自動轉為保守」的機制,答案來自兩個行業拼起來——
向保險精算借「信心的公式」。Hans Bühlmann(1967)處理「新保戶數據太少,該信幾多」的標準方法:
m=0 時 Z=0,全用群體先驗(新保戶交平均保費);數據累積,Z 趨向 1,逐步過渡到用自己的紀錄。
向高盛借「拉回市場」的結構。Black 與 Litterman(1992,高盛)當年的難題:把自家回報預測直接餵入優化器,輸出永遠走向極端倉位。修正:以市場均衡回報作先驗,私人觀點按信心加權併入——
融合點:Black–Litterman 給了結構(市場先驗+私人觀點+信心權重),但沒說信心從何而來;Bühlmann 剛好補上信心的公式(ZZZ 由數據量決定)。兩樣原料都已在庫——私人觀點=樹的三情境機率;市場先驗=現價反推的三情境機率;數據量 mmm=樹的證據覆蓋:
另設預警:現價 ≤ 熊市目標 × 1.1,持倉自動標記「須重新覆核估值」。
AMBA 由頭到尾逐步重算(2026-07-21 庫內實數)
① 證據覆蓋 m=0.843:
② 樹的機率:牛 0.34/基 0.66/熊 0
③ 修正後目標價:熊 $39.8/基 $95.92/牛 $118.3;現價 $61.84 在熊與基之間
④ 逐情境混合:
⑤ 期望回報:
⑥ Kelly:
Half-Kelly:0.65;單名上限 15%;歸一化後 → 最終注碼 2.9%。
AMBA 補好了。其餘 71 棵樹呢?
而最可疑的,是那張權重表——2.5、1.6、0.9、0.4、0.15,全是我親手寫下的數字。憑什麼相信它們是對的?
自我修正:向核電業借「先信手冊,後信紀錄」
核電廠不信任何一個開機當天寫下的數字。
它算一個零件的失效率,先用手冊上的出廠值,再按這台機運行多年的實際紀錄,逐年往回改。
本篇借來的每一條公式,出身行業都有這個習慣:初始參數來自專家判斷,之後交給數據修正。核電、精算、可靠性工程,沒有一個把開機那天的猜測當真理。
系統照辦,把修正拆成三層,剛好排成一條時間線:一層已上線,一層剛出數,一層在等樣本。
第一層|建樹時檢查(已上線)
flip-test 在建樹或改權重時即時運行:你說這條分支斷了信念會跌到 0.12,引擎就真的模擬它斷掉,看是不是 0.12。
第一次全艦隊運行,144 個不一致。正是這 144 個缺口,逼出了第三步的引擎改寫;改寫後歸零。
這一層守的是內部一致性——系統有沒有做到自己承諾的事。
第二層|事件對帳(剛開始出數)
校準表走出系統,去對外面的世界:每一次判定轉變,配上那條分支的等級,再配上其後股價的實際走勢。
靈魂拷問:我寫下的等級,跟真實市場有沒有半點關係?
2026-07-21 校準表,964 個事件,54 隻股票 。
下調後一週平均 −1.5%(73 個有前向價格的事件)
上調後一週平均 −0.4%,貼近零。
把下調事件按等級拆開:
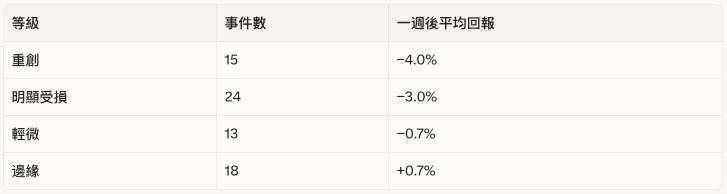
等級愈重,跌得愈深,四級一路排下去,沒有一級亂位。
這件事本來大可以不發生。這四個數字之間,有 24 種可能的排法,市場只需隨便挑其中 23 種,這張表就是一堆噪音,這篇文章就到此為止。它偏偏挑中了唯一正確的那一種。
這些等級不是回歸擬合出來的最佳解,不是拿股價倒推的結果。寫的時候,沒有任何一個市場數據參與過。
然後這張由人腦 (with AI) 寫成的嚴重程度表,第一次拉去對真金白銀的市場回報,市場照着同一個順序,把跌幅由深到淺替我排好。
主觀的先驗,與客觀的結果,第一次在沒有商量過的情況下對上——而且對得整整齊齊。
方向也一併對上:壞消息帶預測力(下調後真跌),好消息接近無訊息(上調後貼零)。這正是第一步分數尺(−3 對 +2)與第三步上行折減(×0.5)當初刻意寫進公式的不對稱。
數據回答:賭對了。
但話不能說滿。樣本淺,事件互有重疊,沒有對照組,遠未達統計顯著。致命級只有 3 例,太少,索性不入表。這是一個訊號,它的份量只在於:一張賭上作者判斷的表,第一次就通過了現實檢驗。這是繼續累積、繼續校準下去的理由。
第三層|統計重校(等樣本)
這張表累積到足夠事件,就升級成第三層:正式檢驗「致命」級證偽後的表現,是否統計上確實差於「邊緣」級;若五級之間分不出差異,等級常數按數據往回改。
這一層的運作,本質上是一次 Bayesian(貝葉斯)更新——這也解釋了為什麼前面那些等級數字,從來不是刻死的。
第二步的衝擊等級由人判斷寫下,是先驗(prior):動工前的最佳猜測。每週的判定轉變連同其後股價,是似然(likelihood):世界對猜測的回應。兩者結合成後驗(posterior):獲數據支持的等級保留,被數據反駁的向實證收縮——收縮幅度,用的正是第五步同一條 Bühlmann 信度公式(同類案例愈多,實證愈話事)。
第二層那張「排序正確」的表,就是這場更新的第一筆likelihood。
哪些數字正排隊等它來修,也就一清二楚:
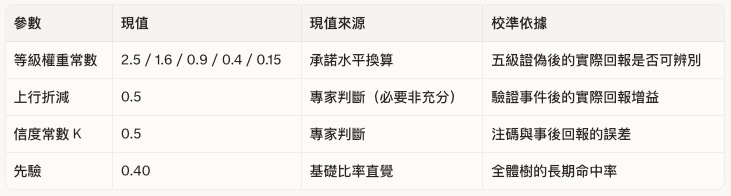
第三步「平均改相加」的決定也在同一框架內:它隱含的假設(分支獨立、多分支同意應提高信心)同樣可檢驗;若數據顯示多分支同意毫無預測價值,這個改動會被撤回,並記錄在案。
每個參數都掛着一組等它來檢驗的數據,每一次出錯都變成修正下一版的依據。系統一定會繼續出錯——目標從來不是不出錯,而是讓每個錯誤可被記錄、量度、用來改下一版。
而本週,這台機器第一次回頭修正了自己,還交出第一個「作者判斷對得上市場」的訊號。
文獻(按借用的行業排列)
科學哲學
Popper, K. (1959). The Logic of Scientific Discovery. Hutchinson.
行為經濟學/大型基建
Kahneman, D. & Tversky, A. (1979). Intuitive Prediction: Biases and Corrective Procedures.
Flyvbjerg, B. (2006). From Nobel Prize to Project Management: Getting Risks Right.
可靠性工程(核電/導彈)
Birnbaum, Z. W. (1969). On the Importance of Different Components in a Multicomponent System. in Krishnaiah (ed.), Multivariate Analysis II.
統計/密碼學
Good, I. J. (1950). Probability and the Weighing of Evidence. Griffin.
Genest, C. & Zidek, J. V. (1986). Combining Probability Distributions. Statistical Science 1(1).
資訊理論/賭注理論(貝爾實驗室)
Kelly, J. L. (1956). A New Interpretation of Information Rate. Bell System Technical Journal 35.
MacLean, L., Thorp, E. & Ziemba, W. (2011). The Kelly Capital Growth Investment Criterion. World Scientific.
Sun, Q. & Boyd, S. (2018). Distributional Robust Kelly Gambling. arXiv.
保險精算
Bühlmann, H. (1967). Experience Rating and Credibility. ASTIN Bulletin 4(3).
量化資產配置(高盛)
Black, F. & Litterman, R. (1992). Global Portfolio Optimization. Financial Analysts Journal 48(5).
估值/預期投資法
Damodaran, A. — 倍數之基本面決定式與跨制度相對化。
Rappaport, A. & Mauboussin, M. (2001). Expectations Investing.
Mauboussin, M. & Callahan, D. (2016). The Base Rate Book. Credit Suisse.
現況
已生效——信念計算的加性合成連同上行折減(tree_quant/4)已在全部樹上重新計算並使用;熊市貼價預警已加入週報;注碼機率混合已於 2026-07-21 接入下單(配接層方式:送往引擎的機率改為有效機率,引擎本身不變,交易日誌保留完整審計欄位);首批 17 棵樹已按衝擊等級重評權重。
試點/逐步採用——歷史階段錨(檢查閘已備,14 個歷史情節的案例庫已建,逐樹遷移)、其餘 55 棵樹的等級重評(分批進行)。信念與注碼的絕對水平尚未經樣本外驗證;本次改善的是結構的一致性與可修正性,不是預測能力的證明。被取代的舊公式原文保留於標準文件。
研究用途,非投資建議。
會員專區:樹的組合 - 一起共建