1. Random variable(隨機變數)
「這個策略過去五年年化 18%」可不可以當成對未來的期望?要答這條問題,先要分清 random variable 和已實現的數據。
Random variable 定義:
它是一個數值
觀測之前結果未定,可以用機率描述。
不需要來自骰子、硬幣這類人造的機會裝置,不需要是整數,也不需要「夠科學」。明日氣溫、明日 S&P 500 回報、下一季出貨量、明年租金,全部都是 random variable。
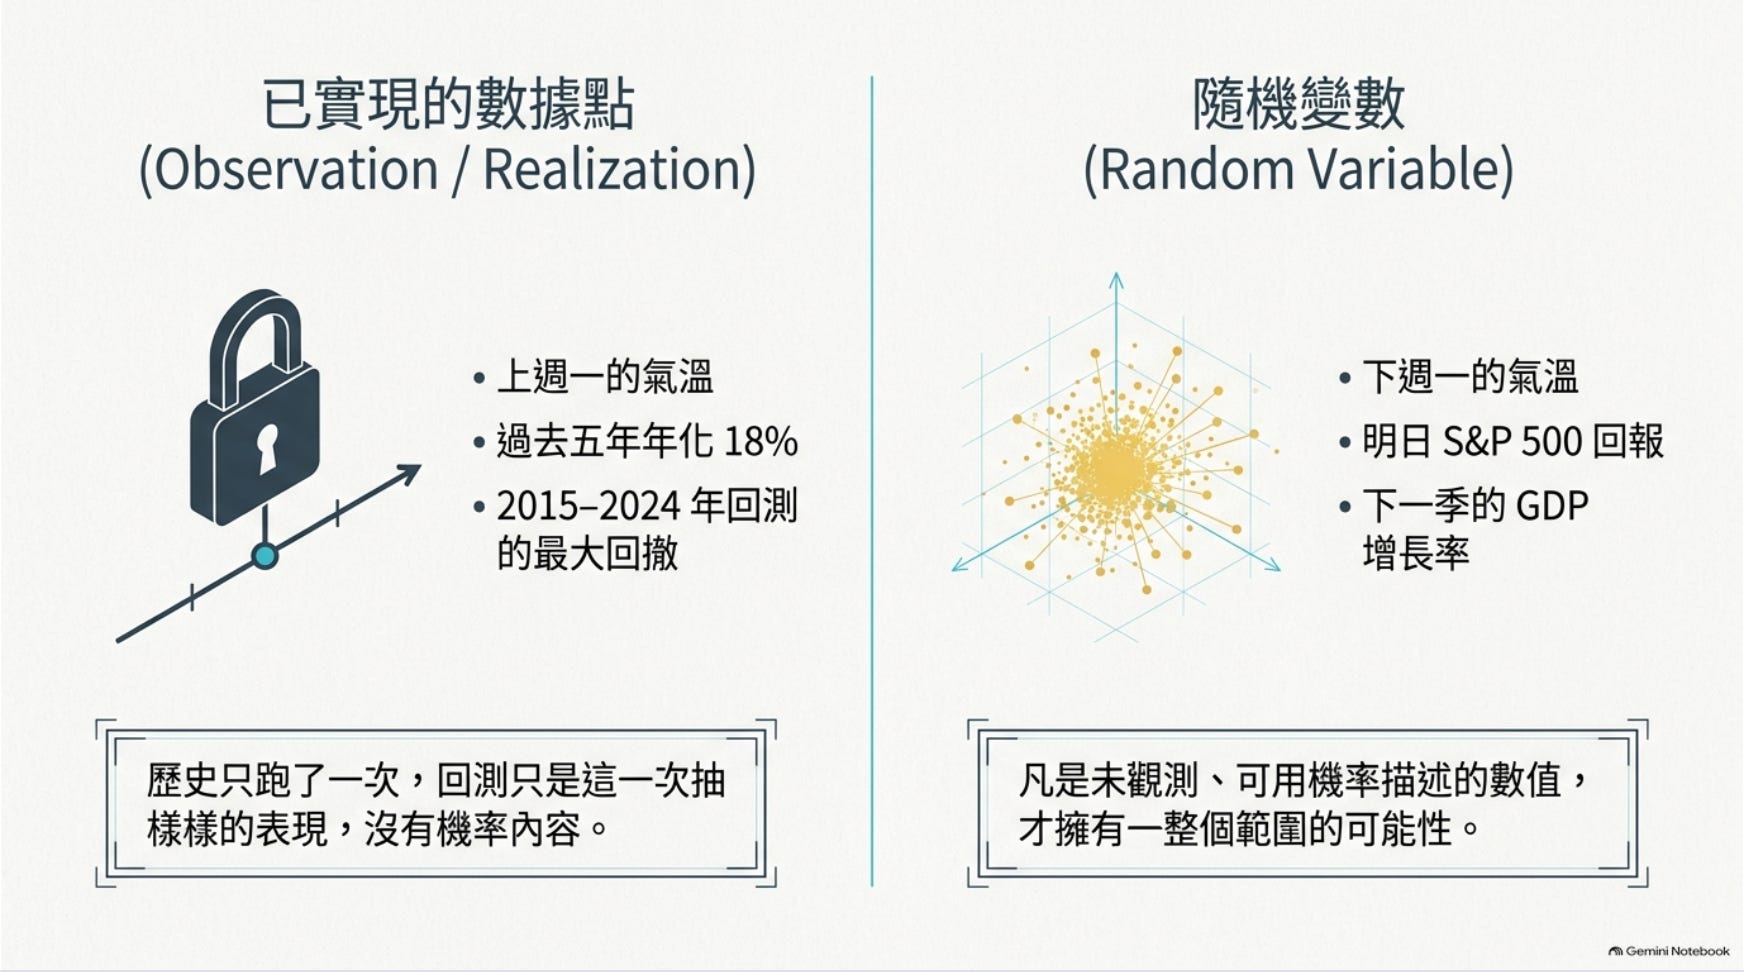
相反,已經發生的,不是 random variable。「上週一的氣溫」已經實現(realization),變成一個觀測值(observation),並不是一個 random variable。
所以:
Random variable:對未來的機率陳述,有一整個範圍的可能性
Realization:已發生的一次抽樣(sample)結果,只是一個數字
歷史數據全部屬於後者。年化回報、最大回撤這些由歷史算出來的統計量(statistic),都是「這一次抽樣」的結果。
凡是未觀測、可用機率描述的數值都是 random variable;已發生的只是 realization。
練習 1 以下哪一項是 random variable?
(a) 你的策略在 2015–2024 年回測的 max drawdown
(b) 恒生指數昨日的收市價
(c) 你的策略下一年的回報
(d) 上一季公佈的 GDP 增長率
答案:(c)。只有下一年的回報尚未觀測。其餘三項已經發生,是 realization。留意 (a):回測結果是策略在歷史這一次抽樣上的表現,歷史只跑了一次,所以它同樣是數據點,不是機率陳述。
2. Continuous variable(連續變數)
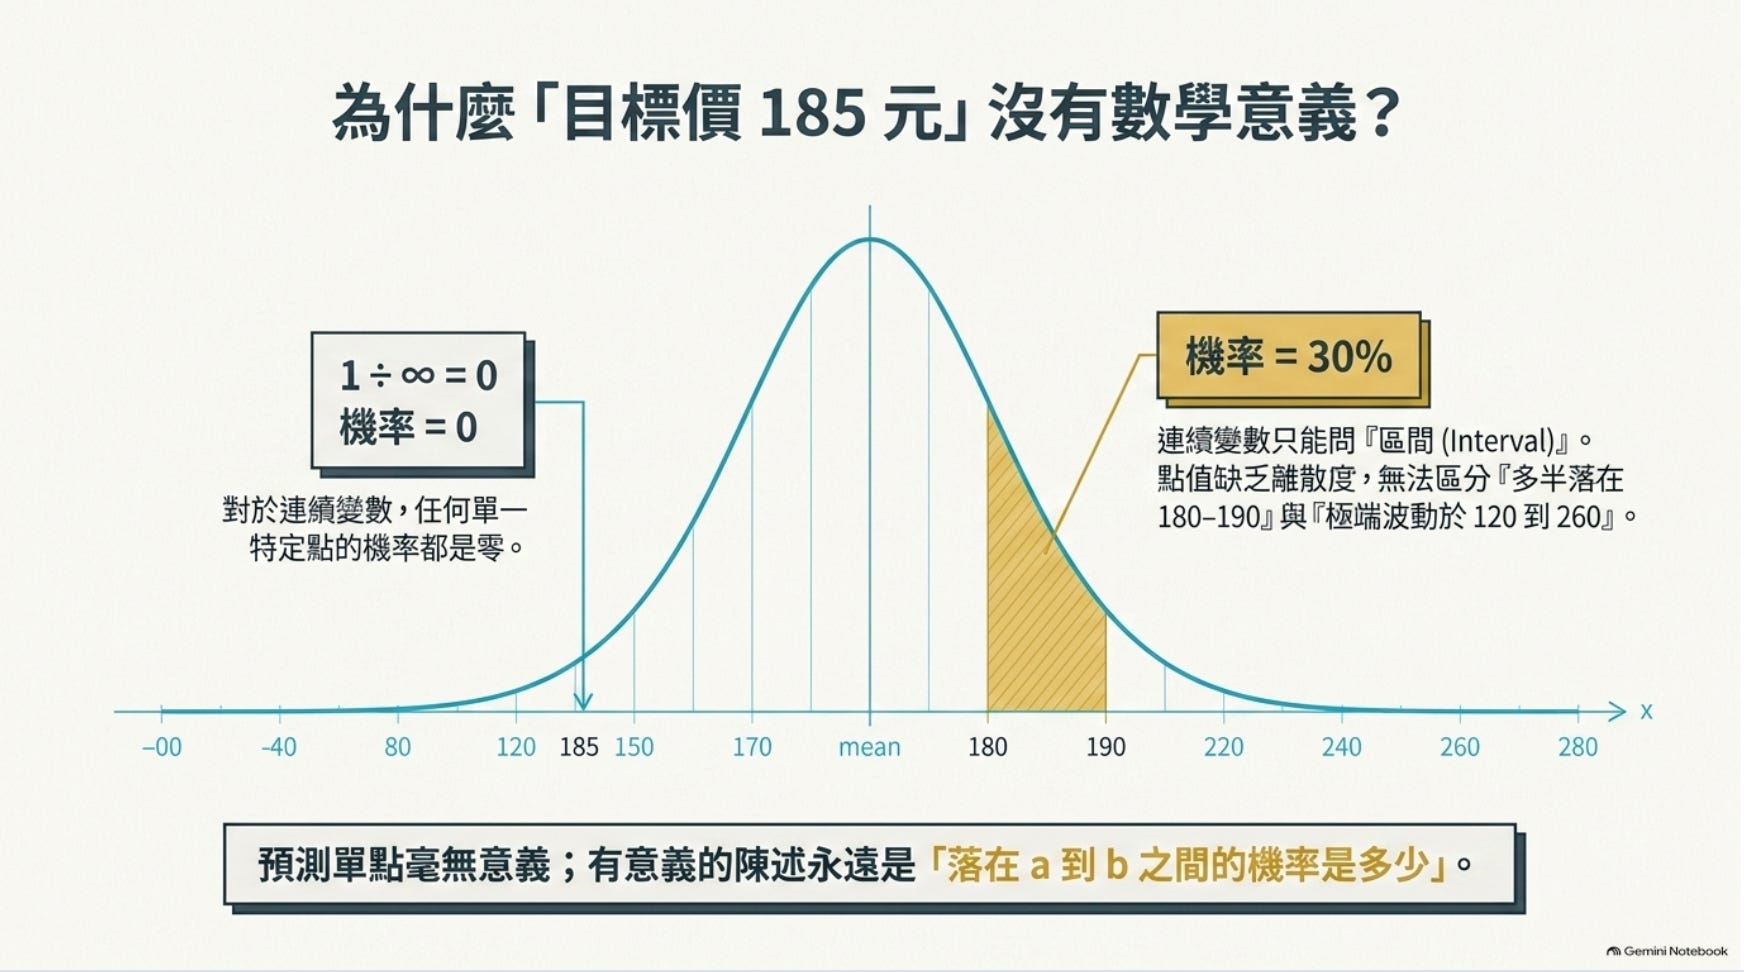
「目標價 185 元」為什麼不足以決定注碼和風險?因為這個陳述在數學上並不成立。
離散變數(discrete variable)可以問單點,例如 P(骰子擲出 3) = 1/6 。
相反,連續變數(continuous variable)不行:0 到 1 之間有無限多個點,任何一個特定點的機率是 1 ÷ ∞ = 0。股價就是其中一種continuous variable 。「明日股價剛好等於185.00000…」的機率是零。非常不專業。
所以連續變數只能問區間(interval),不能問點。有意義的陳述形式是「落在 a 到 b 之間的機率是多少」。
另外,點值它不帶離散度(dispersion)。「185」沒有講明是「多半落在 180 至 190」還是「可能 120、也可能 260」。兩種情況中心點相同,含義完全不同,注碼和 stop loss 的設法也完全不同。
對 continuous variable,只有區間陳述才有機率內容。
練習 2 以下哪一句對 continuous variable 是有意義的機率陳述?
(a) 「明日回報剛好等於 +0.5% 的機率是 3%」
(b) 「明日回報高於 +0.5% 的機率是 30%」
(c) 「density 在 +0.5% 處等於 3,所以該點機率是 300%」
(d) 「目標價 185 元,命中機率 5%」
答案:(b)。「高於 +0.5%」是一個區間,有機率內容。(a)(d) 是單點陳述,機率為零;(c) 把 density 當成了機率,第 4 節會講這個錯。
3. CDF(cumulative distribution function,累積分佈函數)
「估值處於歷史第 85 percentile」「這個 stop loss 多久觸發一次」,這類問題全部需要用 CDF。
想像一條極長的走廊,地上鋪滿沙,有些位置厚,有些薄,兩端遠處幾乎沒有。全世界只有一桶沙,全部倒在這條走廊上。沙的分佈,就是機率的分佈。
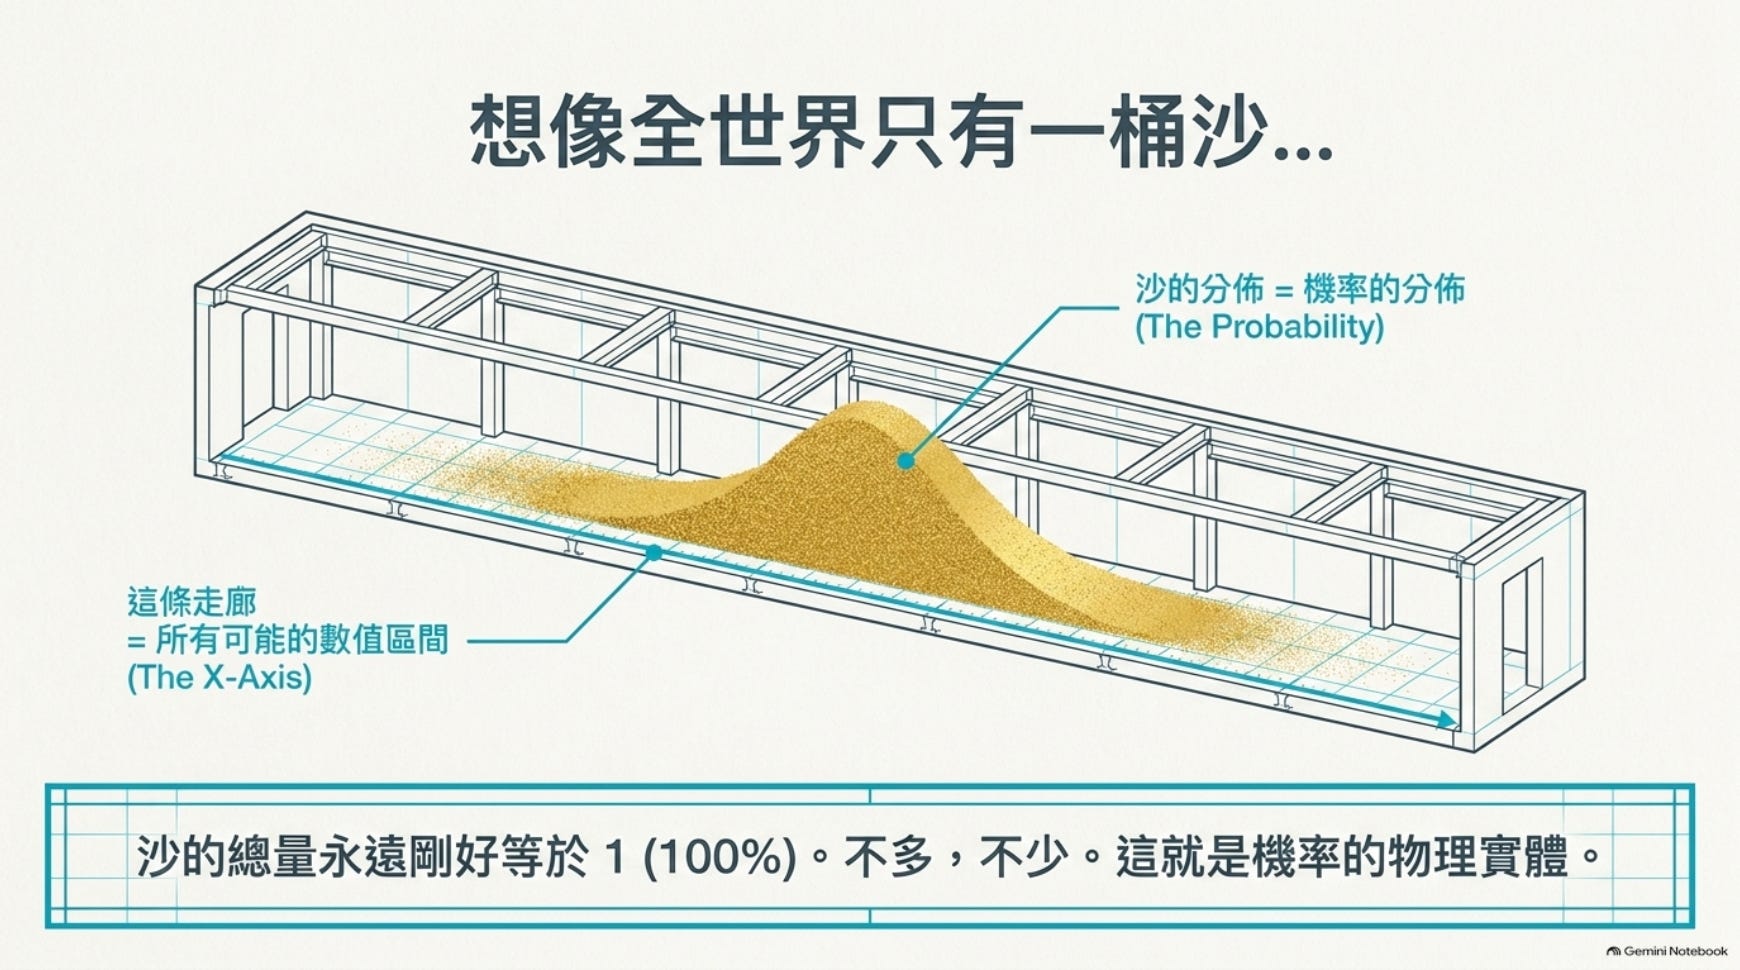
CDF 的定義:拿掃把從走廊最左邊掃到 x,F(x) 就是袋裡累積的沙量。由此得到三個性質:
F(−∞) = 0(一粒未掃)F(+∞) = 1(整桶掃完)F單調遞增(monotonically increasing,袋裡的沙只增不減)。
所以,若果我們需要找某一段區間(Interval)的概念,只需要把右邊減去左邊就可
P(a ≤ X ≤ b) = F(b) − F(a)掃到 b 的量,減掃到 a 的量,左邊重複掃過的部分自己抵銷。有了 CDF,任何區間機率都是一次減法,不用積分。
例:回報落在 ±1 個標準差(standard deviation)之間的機率是 0.8413 − 0.1587 = 0.6827。統計學常背的「一個標準差涵蓋 68%」就是由此推導。
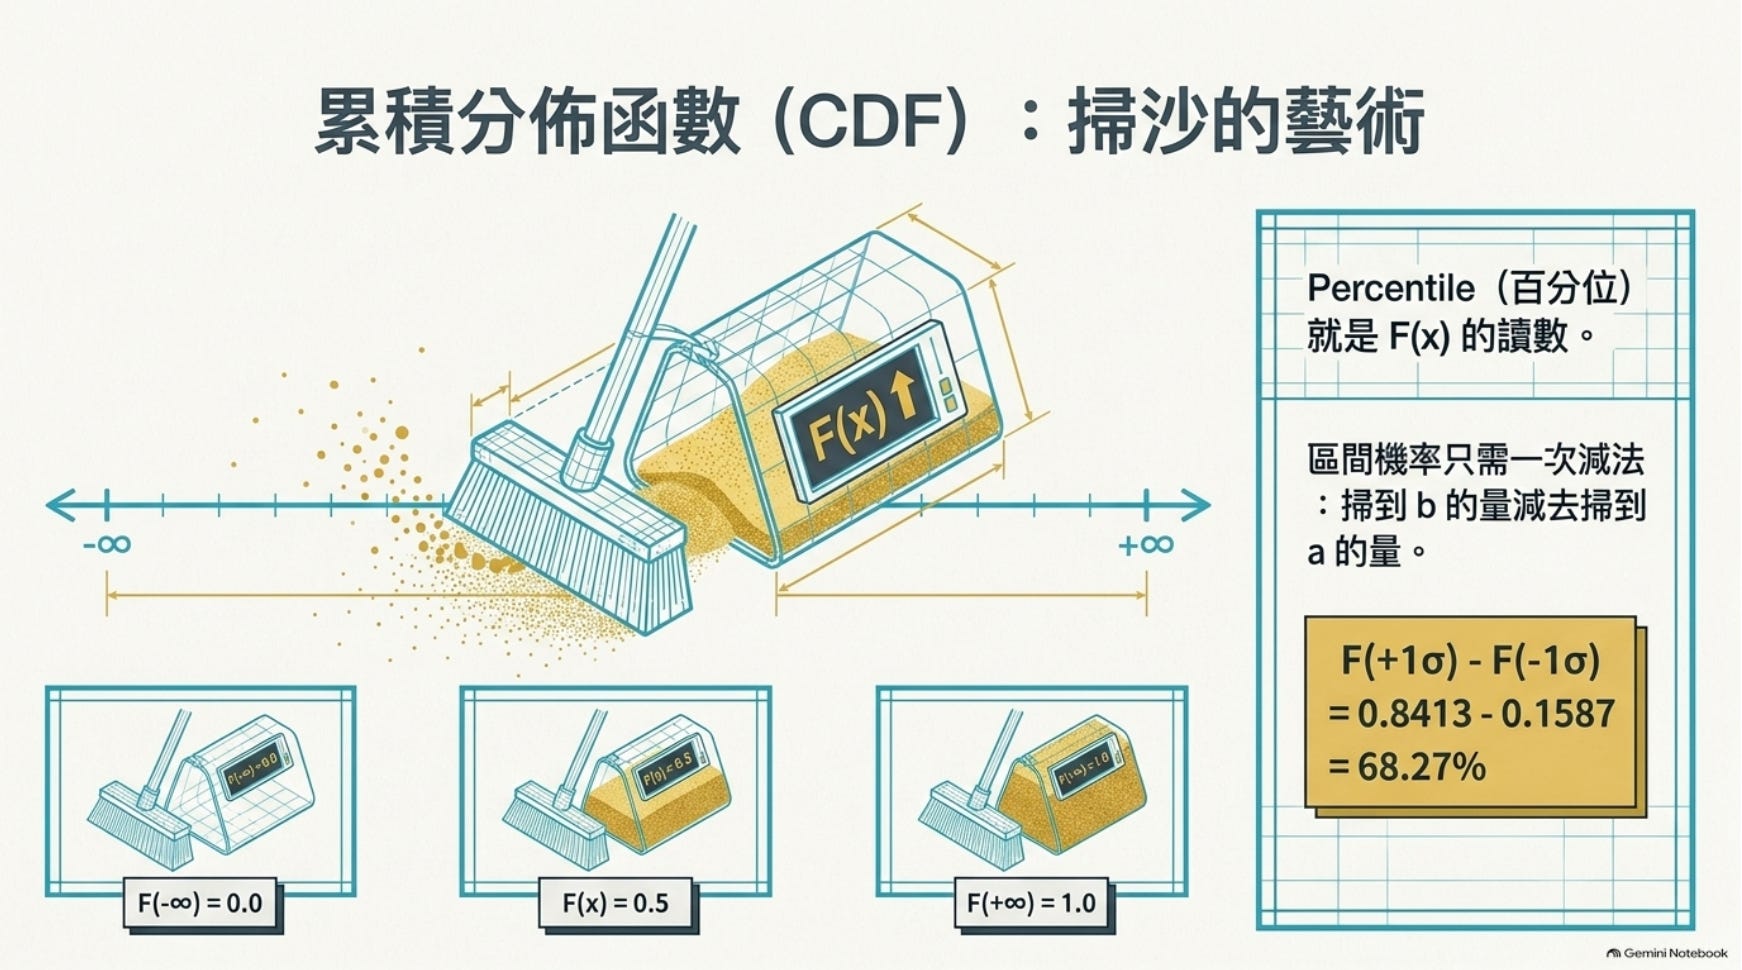
Percentile(百分位)就是 CDF 的讀數:「處於第 85 percentile」即 F(x) = 0.85。
CDF 把所有區間機率變成一次減法;percentile 就是
F的讀數。
練習 3 已知某股票單日回報的 F(−5%) = 0.08、F(+5%) = 0.90。回報落在 −5% 至 +5% 之間的機率是?
(a) 0.90
(b) 0.98
(c) 0.82
(d) 0.72
答案:(c)。0.90 − 0.08 = 0.82。答 (a) 的話漏了減去左邊;(b) 錯在把兩個數相加。
4. Density(probability density,機率密度)
分佈圖的Y軸就是 density。讀錯它有兩個常見後果:把 density 當機率,或者見到 density 大於 1 就以為圖畫錯了。
Density p(x) 是走廊第 x 點的沙有多厚。厚度不是沙量;某段的沙量要用厚度乘寬度:
P(a ≤ X ≤ b) = ∫[a→b] p(x) dx符號意思:
p(x): 厚度dx:一小段寬度p(x) dx這一小段的沙量∫[a→b]由a到b全部加起來(∫ 是拉長的 S,S = Sum)
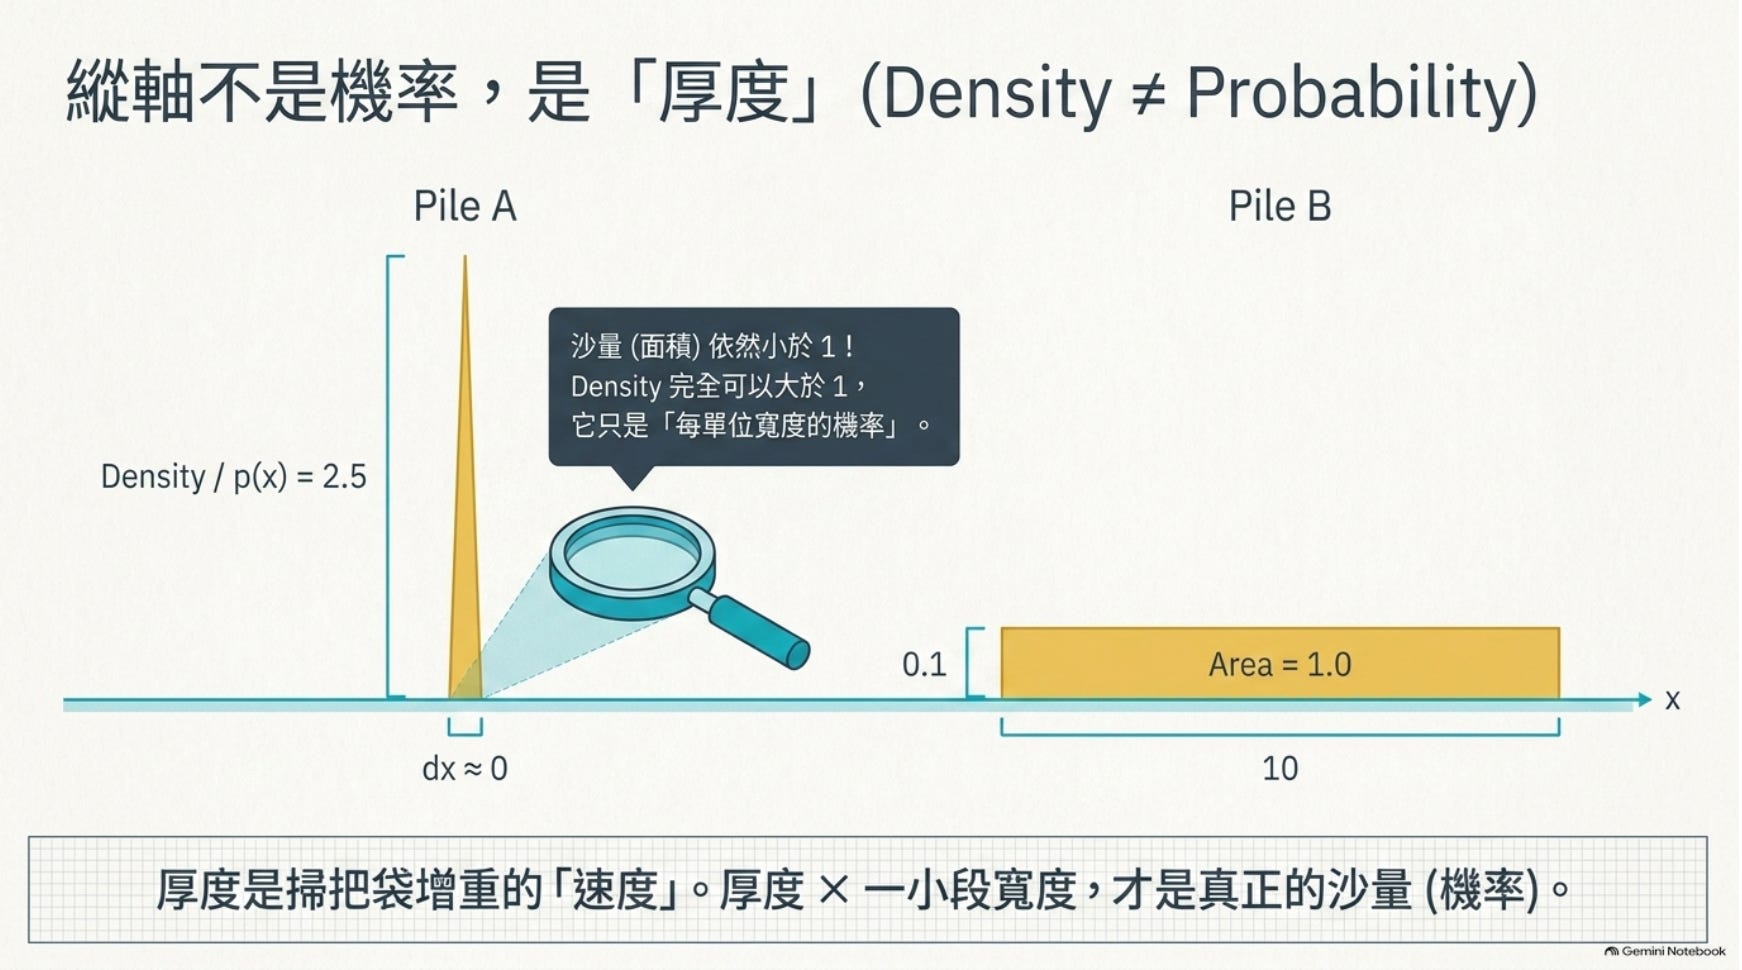
這也解釋了第 2 節:單點的寬度是 0,厚度再高,乘 0 都是 0。
Density 和 CDF 是一對相反的操作:
p(x) = dF(x)/dx厚度等於掃把袋增重的速度。
積分(integration)把厚度累積成總量,微分(differentiation)把總量還原成厚度。
至於 density 大於 1:完全合法。Uniform distribution 在 [0, 0.1] 上的 density 是 10。Density 是「每單位寬度的機率」,不是機率本身,受限制的是整條的積分要等於 1,不是任何一點的高度。
density 乘寬度才是機率;density 本身可以大於 1。
練習 4 某連續分佈在 x = 0 處的 density 是 2.5。可以得出什麼結論?
(a) 這個分佈不合法,因為機率不能超過 1
(b)
P(X = 0) = 250%(c) 只要整條 density 積分等於 1,這完全合法
(d) 這個變數其實是 discrete variable
答案:(c)。(a) 和 (b) 是同一個誤讀:把每單位寬度的機率當成了機率。
5. 合法分佈的兩條規則
由賠率或 option 價格反推的「市場機率」,加起來永遠不是 100%。知道規則,才知道多出來的那截是什麼。
概率只有兩條規則:
非負(non-negative),沒有負機率
總和為 1,Discrete Variable 加總為 1,Continuous variable 積分為 1
一條可以手算的檢查題:p(x) = x² 在 [0, 1] 上合法嗎?非負,但 ∫[0→1] x² dx = 1/3,只倒了三分之一桶沙,不合法。(手算微積分,沒有忘記吧?)
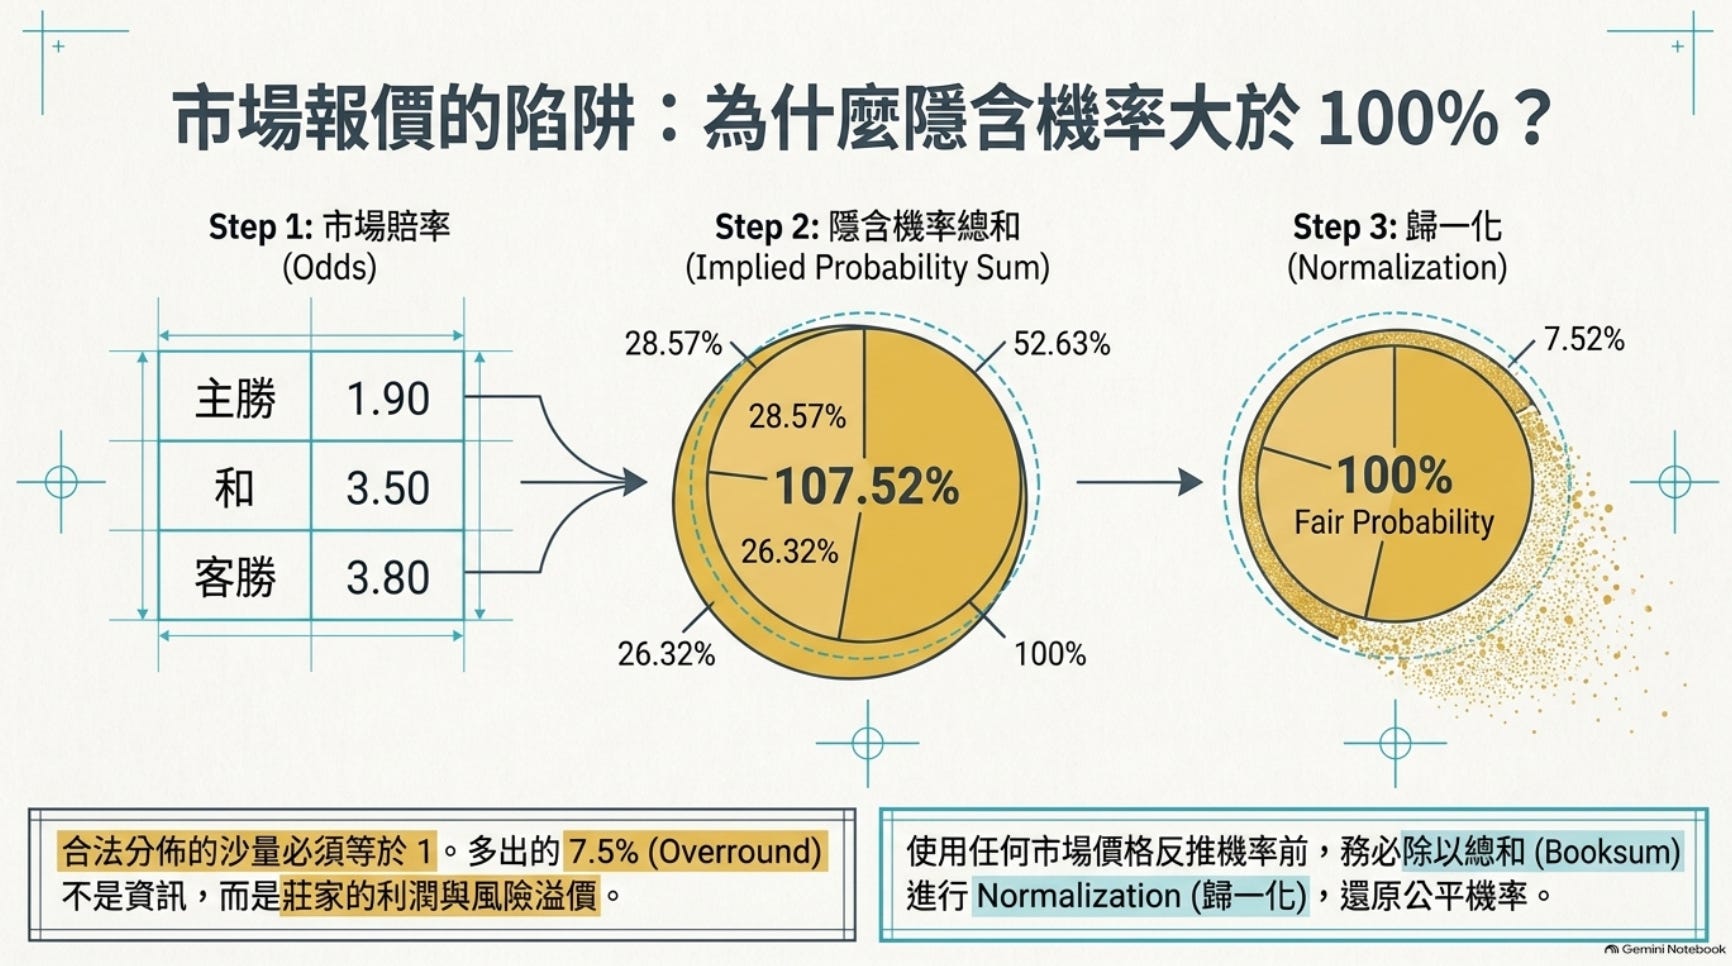
實際應用在賠率上。一組足球賠率(歐洲小數制):主勝 1.90、和 3.50、客勝 3.80。賠率的倒數是 implied probability(隱含機率):
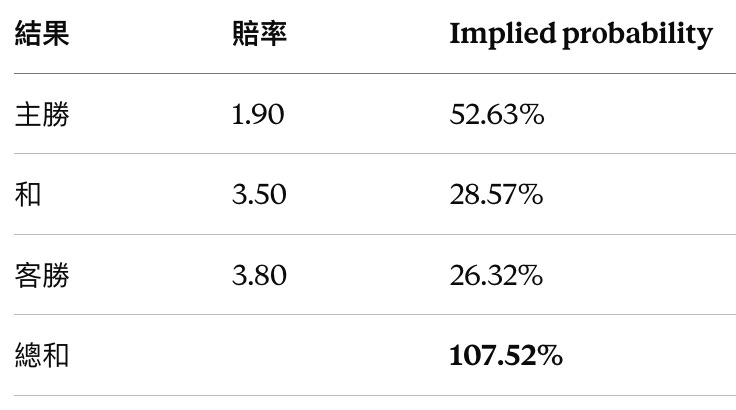
總和大於 1,違反規則二。多出的 7.52% 不是機率,是莊家的利潤;業界叫這個總和做 booksum,超出 1 的部分叫 overround。想還原市場的看法,把每項除以 1.0752,加總就回到 100%。
這不只適用於賭盤。任何由市場價格反推的「機率」(option、prediction market、credit spread)都混有成本和風險溢價(risk premium),加總不會是 1。不先 normalize 就拿來用,等於把莊家的利潤當成自己的優勢。
機率加總必須為 1;市場報價反推的「機率」加總大於 1,多出的部分是成本,不是資訊。
練習 5 某賽事三個結果的 implied probability 加總為 108%,其中一個結果的 implied probability 是 54%。它的公平機率(fair probability)是?
(a) 54%
(b) 50%
(c) 46%
(d) 58.3%
答案:(b)。54% ÷ 1.08 = 50%。
6. Inverse transform sampling
backtest 只有一條歷史。想知道策略在另外一萬條「本來也有可能發生」的歷史裡表現如何,就要自己生成一萬條模擬的價格路徑,這就是Monte Carlo simulation(蒙地卡羅模擬),是量化研究測試策略穩健性的基本工具。生成路徑要用到隨機數,而這一節講的就是:電腦只會出一種最單調的隨機數,怎樣把它變成任何想要的分佈。
手機遊戲的抽卡機制通常是這樣:90% 出普通卡,10% 出稀有卡。電腦怎樣實現?
電腦最容易生成的隨機數只有一種:0 到 1 之間的 uniform random number(均勻隨機數),記作 u,0 到 1 之間每個位置出現的機會完全一樣。遊戲公司的寫法是:
抽到
u < 0.90,派普通卡抽到
u ≥ 0.90,派稀有卡
0 至 0.9 這一段佔了整條線的九成,所以九成的 u 會落在裡面。就這麼簡單:在 0 到 1 的線上切段,段有多長,機率就有多大。
三種卡也一樣。60% 普通、30% 稀有、10% 傳說,就切在 0.60 和 0.90 兩個位置:u 落在 0 至 0.60 派普通,0.60 至 0.90 派稀有,0.90 至 1 派傳說。
留意那兩個切點是怎樣來的:0.60 是第一種卡的機率,0.90 是頭兩種卡的機率加起來。切點就是累積機率。而「累積機率」正是第 3 節的 CDF。遊戲公司一直在做的事,就是「拿一個 0 到 1 的隨機數,去 CDF 反查它屬於哪個結果」。
什麼是反函數(inverse function)
第 3 節的 F(x) 是一部機器:放入一個位置 x,它吐出一個沙量。「掃到 20.09 元這點,袋裡有 0.4 桶」,就是 F(20.09) = 0.4。
反函數就是同一部機器倒轉用:放入一個沙量,它吐出一個位置。「哪個位置掃到 0.4 桶?」答「20.09 元」。
日常生活裡到處都是這種倒轉查。電話簿由名字查號碼,來電顯示由號碼查名字,同一本簿,兩個方向。匯率表由港幣查美元,也可以由美元查港幣。馬拉松成績表由名字查完賽時間,也可以由「第 100 名」反查那人跑了多久。
倒轉用的 F 記作 F⁻¹。那個「−1」只是「反過來查」的記號,不是負一次方,不是 1 除以 F。F⁻¹(0.4) 讀作:「掃到 0.4 桶沙的位置在哪裡?」
連續版本:把 u 讀成沙量
抽卡是離散(Discrete Variable) ,只有兩三種結果。股價回報是連續 (Continuous Variable) ,結果有無限多個,但方法完全一樣,只是「切段」變成了「掃沙」。
抽到 u = 0.37,指令是:從走廊最左邊開始掃沙,袋裡累積到 0.37 桶就停,你腳下那一點就是這次抽樣的結果。用符號寫就是 x = F⁻¹(0.37)。
抽到 0.5,停在掃到半桶沙的位置,即中位數(median)
抽到 0.95,已經走到走廊尾部(tail)
為什麼厚沙的地方自然會被抽中較多
假設走廊中間有一段只長 10 厘米,但沙極厚,佔全部沙的 50%;右邊另有一段長 10 米,沙很薄,只佔 5%。
u 是均勻的 (u 是由電腦在0 到 1 之間的 uniform random number),所以 u 落在「對應那 50% 沙」的範圍的機會就是 50%。換句話說,一半的抽樣會停在那 10 厘米之內;停在那 10 米薄沙段的抽樣,只有 5%。
對比一下抽卡:普通卡佔 0 至 0.9 這條長段,所以常抽中;稀有卡佔 0.9 至 1 這條短段,所以少抽中。走廊版本同一道理,只是「段」由卡的機率變成了沙量。厚沙段在 u 的世界裡佔一條長段,所以常被抽中。密度的形狀就是這樣被複製出來的。
實測
以 100 萬個 uniform 隨機數代入 x = −ln(1−u),這是 exponential distribution(指數分佈)的 F⁻¹,即這個分佈的「反查公式」(式中的 ln 下一節會解釋)。理論上落在 x < 1 的比例應為 63.21%,實測 63.16%。
限制:這方法要求 F⁻¹ 寫得出一條式。常態分佈(normal distribution)寫不出,實務用數值反演(numerical inversion)或 Box-Muller 等方法代替,概念相同。
抽卡遊戲用一個 0 到 1 的隨機數切段派卡;inverse transform 是它的連續版,把
u讀成沙量、用 CDF 反查位置。這是 Monte Carlo 模擬的引擎。
練習 6 抽到 u = 0.5,代入 F⁻¹ 得到的數值一定是這個分佈的?
(a) 平均值(mean)
(b) 中位數(median)
(c) 眾數(mode,density 最高的點)
(d) 視乎分佈形狀,三者都有可能
答案:(b)。掃到半桶沙的位置,按定義就是 median。Mean 會被長尾巴拉開,mode 是沙最厚的一點;三者只有在對稱分佈才重合,所以「一定」只能選 (b)。
7. 換元(change of variables):同一堆沙,兩把尺
量化分析常做單位轉換,股價轉 log price、P/E 轉 earnings yield、小數轉百分比。每次轉換,分佈的形狀都會跟著變。這一節講它怎樣變,順便為什麼股價分佈天生是歪的。
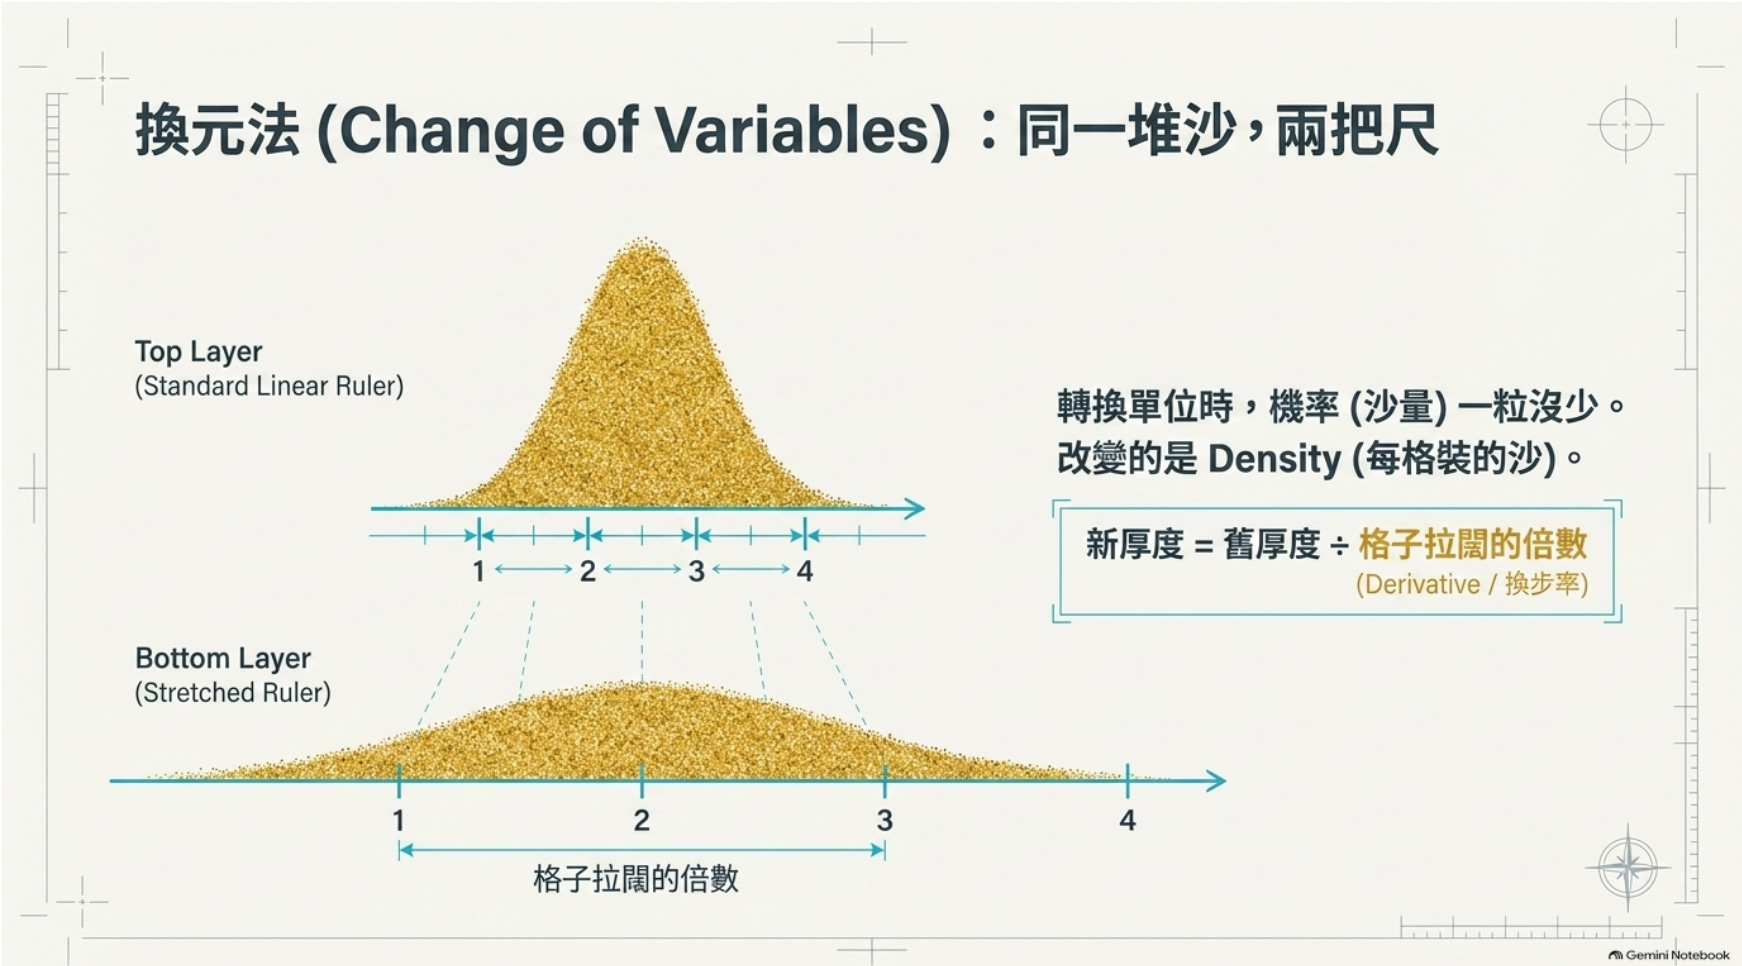
先用一個和金融無關的例子。100 萬人的身高資料,用厘米記錄時「169 至 170cm」這格有 6.62% 的人。改用英吋記錄(1 英吋 = 2.54 厘米),人一個都沒有多,但英吋尺上一格闊 2.54 厘米,等於舊尺兩格半,一格裝的人自然變成約 16.8%。
機率(人數)不變,density(每格的人數)變。 沙一粒沒有多沒有少,只是走廊被拉長或壓縮,每格的沙跟著變。寫成規則:
新厚度 = 舊厚度 ÷ 格子拉闊的倍數
走廊拉長 3 倍,同一撮沙攤薄在 3 倍長的地上,厚度除以 3;壓縮一半,沙堆厚一倍,除以 0.5 等於乘 2。數學記法只是這句話的縮寫:
g(y) = p(x) / |dy/dx|p(x) 是舊厚度,g(y) 是新厚度,|dy/dx| 是拉闊倍數。
dy/dx 這個記號叫 derivative(導數),意思是換步率:在舊尺走一小步 dx,新尺跟著走了 dy,相除就是倍數。厘米轉英吋,倍數處處是 2.54。麻煩的尺是拉得不均勻的:左邊走一步它跟一步,右邊走一步它跟十步,這種尺的拉闊倍數要逐點問,導數隨位置改變就是這個原因。
ln 是什麼
下面要用 log,先重溫log 的概念。普通的尺走一步是加一個固定數:1、2、3、4。Log 的尺走一步是乘一個固定倍數:1、10、100、1000,這是以 10 為底的 log,每步乘 10,log₁₀(1000) = 3 讀作「由 1 到 1000 要走 3 步」。ln(natural log,自然對數)同一個道理,只是每步乘的不是 10 而是 e ≈ 2.718(一個數學上方便的常數,來歷可以不理)。ln S 讀作「在這把每步乘 2.718 的尺上,S 位於第幾步」。
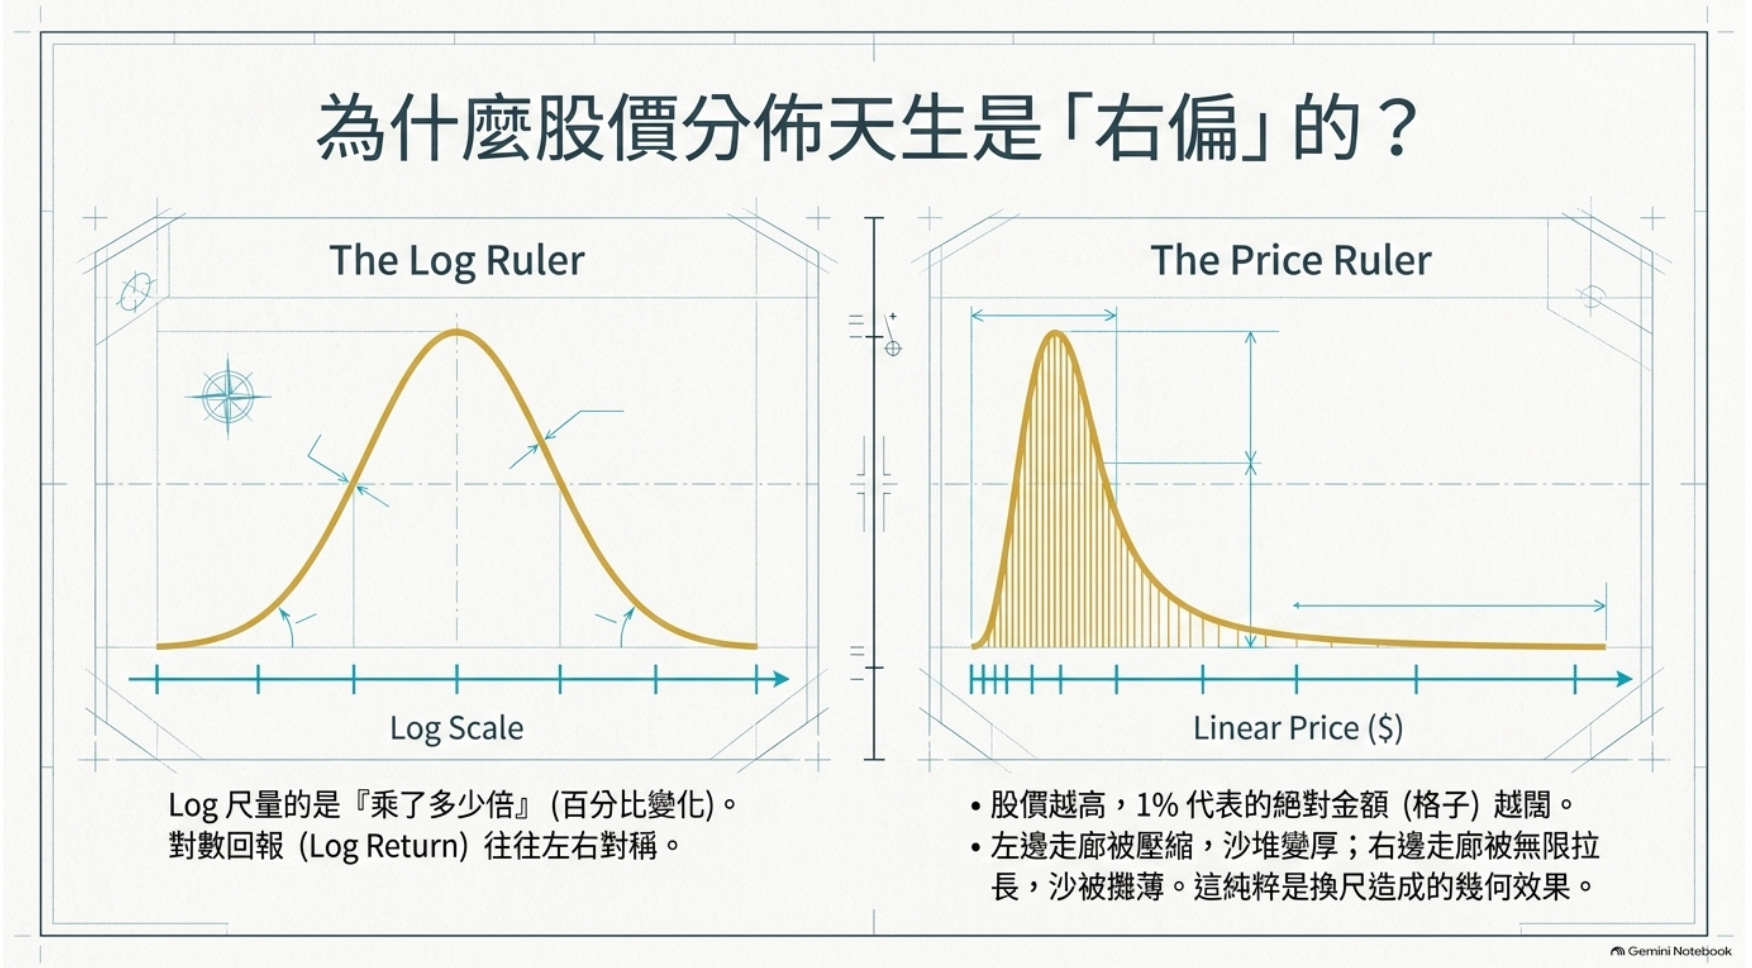
普通尺量相差多少,log 尺量乘了多少倍。所以 log 尺天生是量百分比變化的尺,金融用它就是這個原因。
股價的例子
設 x = ln S,即在 log 尺上走到第 x 步時股價是 S。逐行讀:
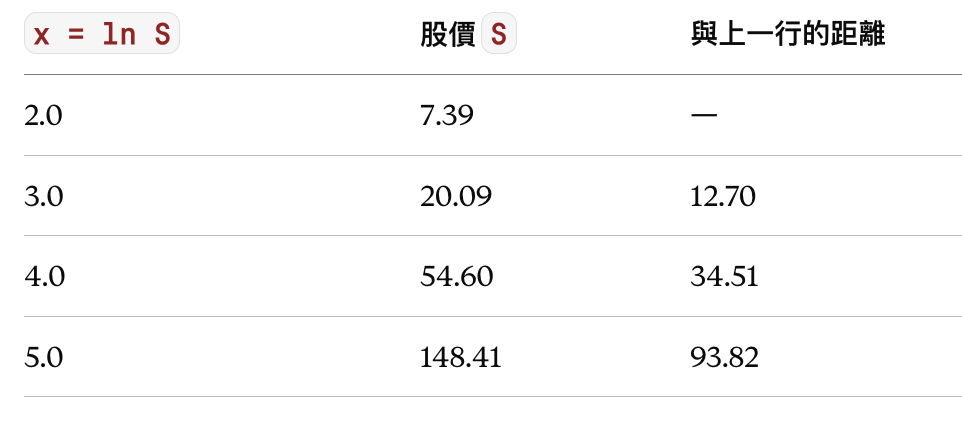
左欄每次加 1,右欄每次乘 2.718。同樣走一步,股價早期只脹十幾元,後期脹近百元:log 尺上均勻的一步,在股價尺上越走越闊。
拉闊倍數是多少?等於股價 S 本身。不用微積分也看得出:log 尺量百分比,股價尺量錢,而「1% 值多少錢」和股價成正比,10 元股票的 1% 是 0.1 元,100 元股票的 1% 是 1 元。股價越高,同一個百分比換到的錢越多,格子拉得越闊。將x = ln S代入公式:
g(S) = p(ln S) / S由此有一個推論:如果 log return 的分佈左右對稱(symmetric),股價的分佈必然右偏(right-skewed),因為左邊被壓窄(沙堆厚)、右邊被拉開(沙攤薄),畫出來左高右拖尾。這是換尺造成的幾何效果,和市場樂觀與否無關。
換尺後機率不變,density 除以拉闊倍數;log 尺每步乘固定倍數,量的是百分比。
練習 7 回報數據原本以小數記錄(0.05),現改以百分比記錄(5),即 y = 100x。新尺上的 density 會?
(a) 乘 100
(b) 除以 100
(c) 不變,因為機率不變
(d) 視乎位置,有些地方乘、有些地方除
答案:(b)。格子拉闊 100 倍,沙攤薄 100 倍。(c) 混淆了機率和 density,不變的是機率;(d) 說的是拉得不均勻的尺,y = 100x 處處拉 100 倍。
所以,一兩只大贏家,住住就會扭轉命運。
8. 平均值與尺的選擇
基金廣告說「平均回報 8%」,買不買?自己組合的「平均 P/E 是 30」,貴不貴?兩個數字都可能錯超過三成,錯因相同:在錯的尺上取了平均。
平均 P/E
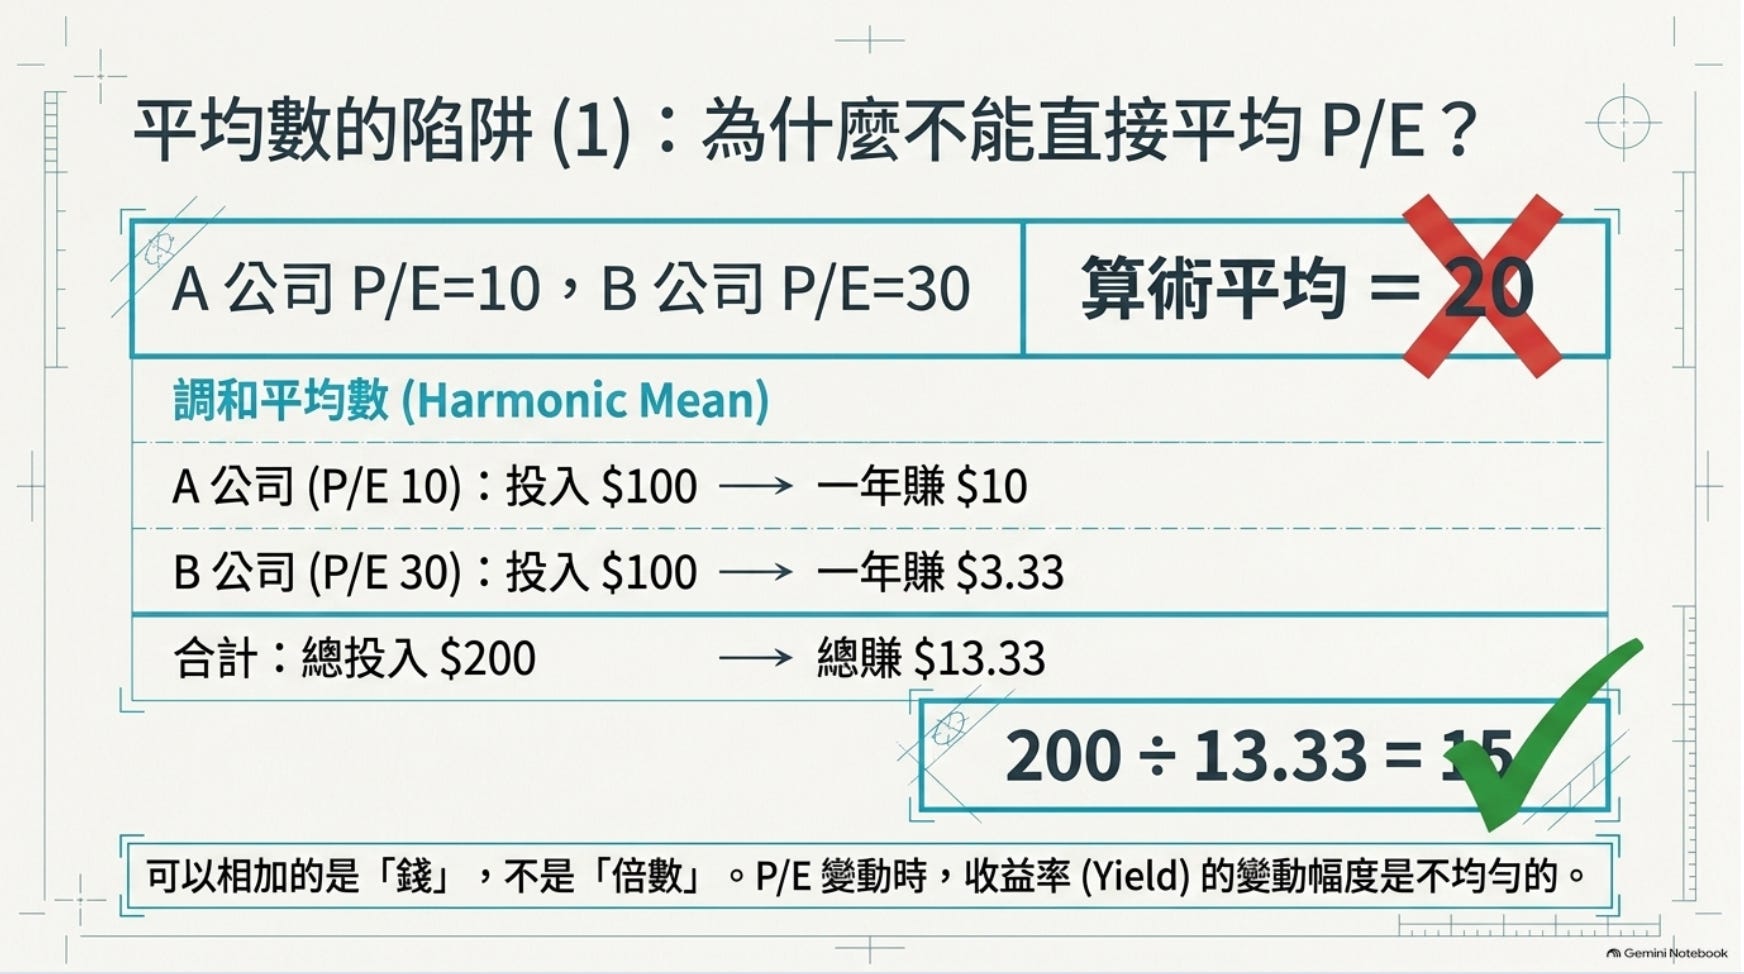
A 公司 P/E = 10,B 公司 P/E = 30,平均是什麼?是20嗎?(20+10)/ 2 =20 嘛。錯!
P/E = 10 的意思是付 10 元買公司一年 1 元的盈利;倒轉讀是 earnings yield(盈利收益率),每 100 元一年賺 10 元。現在各投 100 元:A 賺 10 元,B 賺 3.33 元(1/30),合計 200 元賺 13.33 元,收益率 6.67%,換回 P/E 是 200 ÷ 13.33 = 15。
所以,答案是 15,不是 20 。
因為可以直接相加的是錢,P/E 這種倍數不能相加。「取倒數」正是上一節那種拉得不均勻的尺:P/E 由 10 到 12,yield 動了 1.67 個百分點;由 28 到 30,只動 0.24 個百分點。同樣走兩格,一邊動了七倍,高 P/E 那端被壓扁,直接平均就被它拉高。
「先轉成錢、平均、再轉回去」有個正式名稱,harmonic mean(調和平均數),指數編製機構計整體 P/E 用的就是它。
平均回報
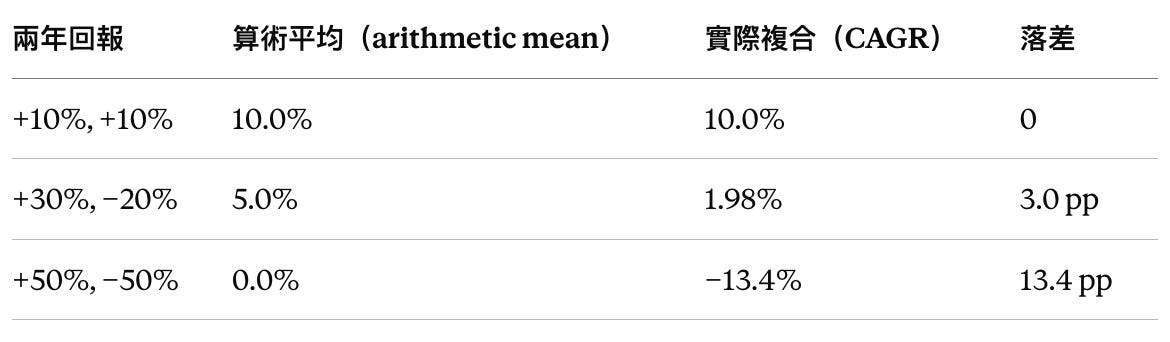
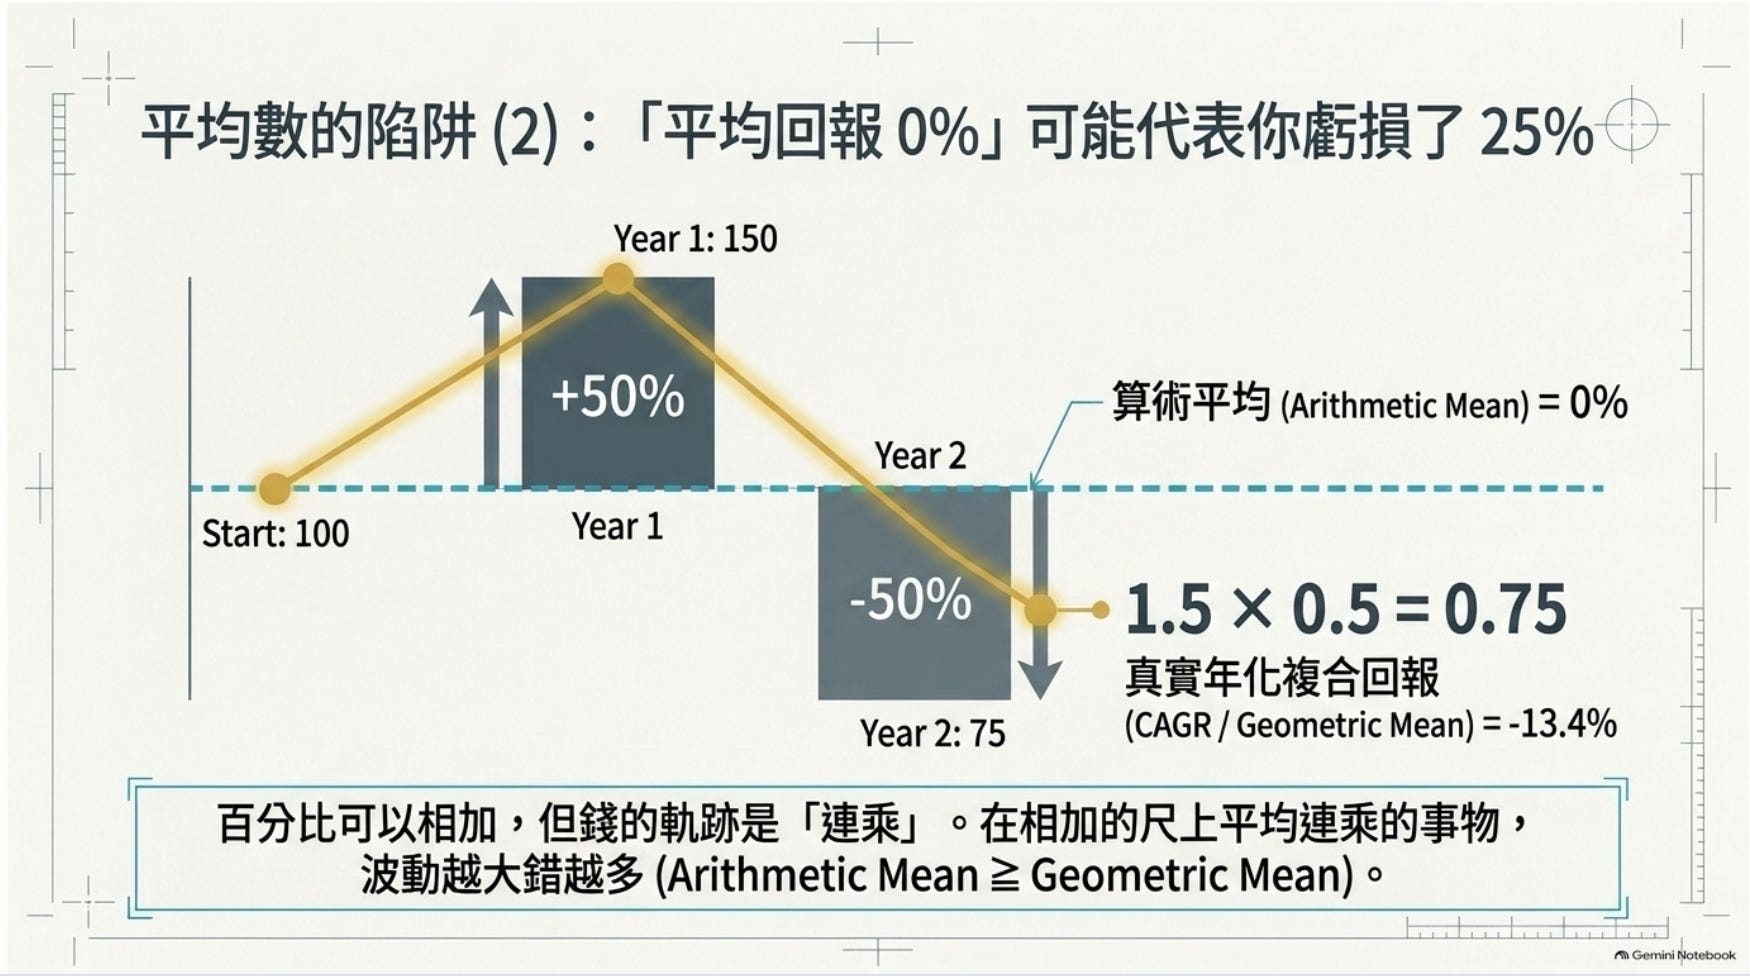
基金第一年 +50%,第二年 −50%,廣告寫「平均回報 0%」,算術上沒錯。用錢走一次:100 元,第一年變 150 元,第二年剩 75 元。兩年虧 25%,折算成固定年率是每年約 −13.4%(0.866 × 0.866 ≈ 0.75)。
「0%」答每年那個百分比數字的平均;「−13.4%」答錢實際的年均變化。你的資產對應後者。
百分比(+50、−50)可以相加,但錢的路徑是連乘(×1.5、×0.5)。在相加的尺上平均一件連乘的事,波動越大錯得越多:
接回上一節:log 尺每走一步是乘一個倍數,所以連乘在 log 尺上剛好變成相加。量化研究普遍用 log return(對數回報),原因就是在 log 尺上取平均,複合效果自動計入,不會出現 0% 對 −13.4% 這種落差。
提醒:log return 跨時間可加,跨資產不可加,計組合(portfolio)單期回報要用簡單回報(simple return)加權。
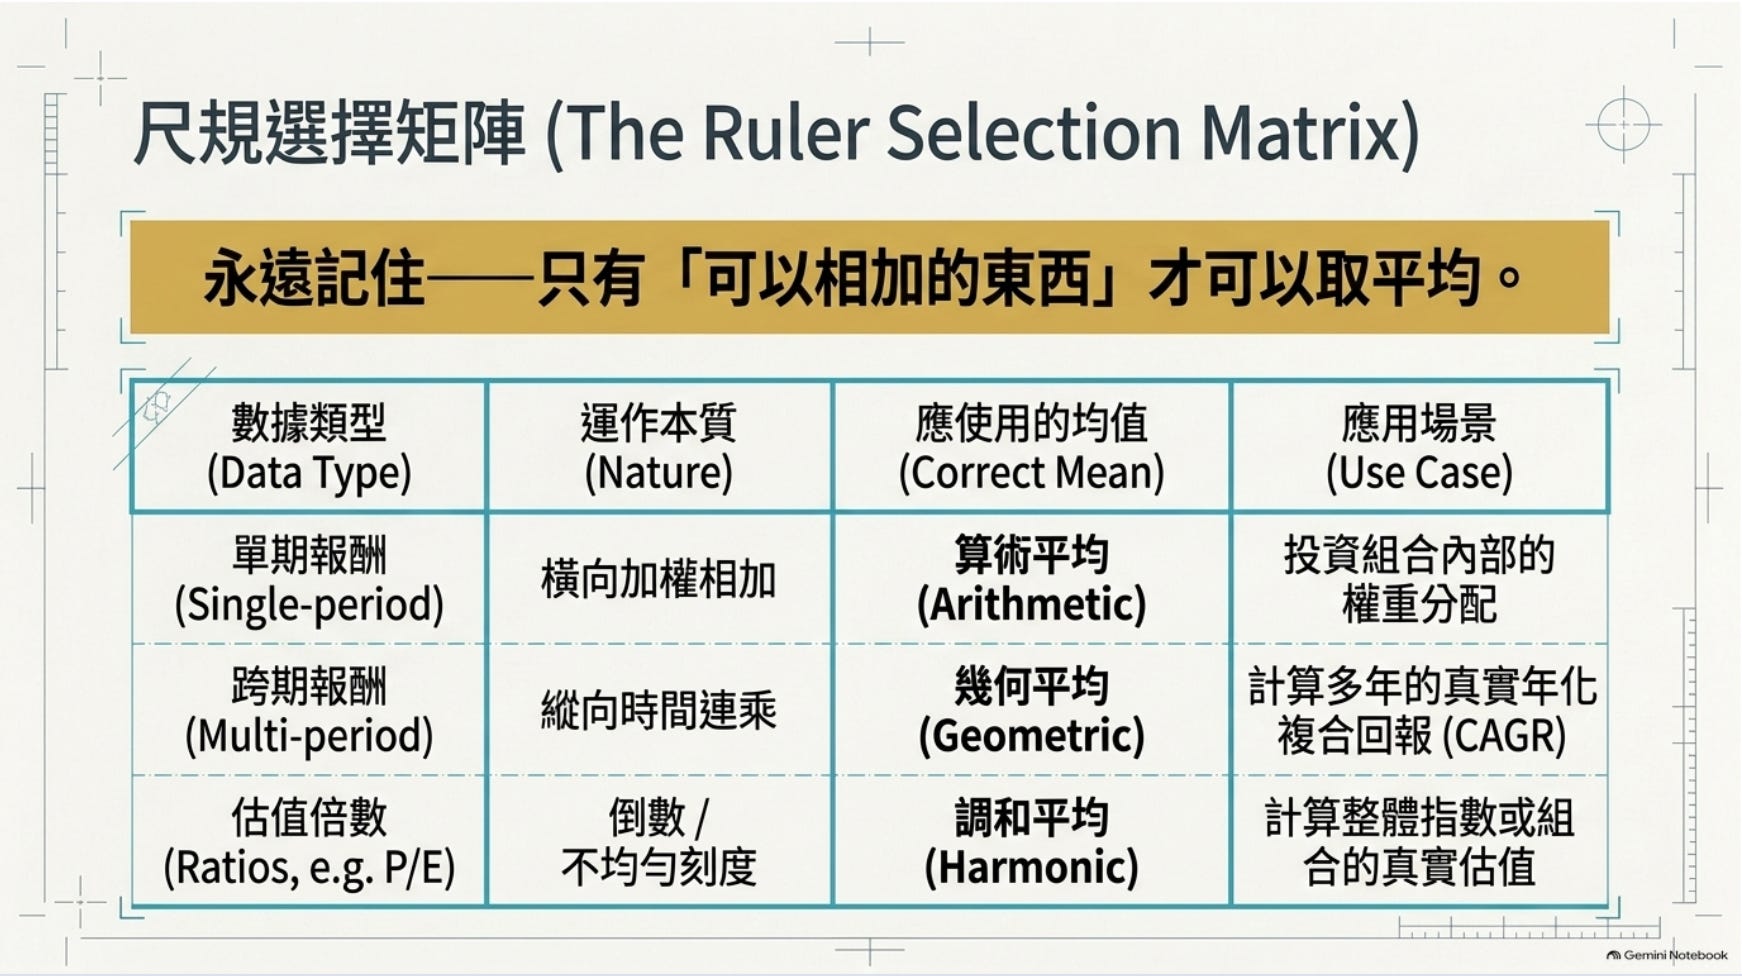
可以相加的東西才可以取平均。P/E 先轉成錢,回報先認清是連乘;選對尺,再平均。
練習 8 組合內兩檔股票 P/E 分別為 12 和 48,各佔一半。哪個數字較接近組合的真實估值水平?
(a) 30(Arithmetic mean 算術平均)
(b) 24(Geometric mean幾何平均)
(c) 19.2(Harmonic mean 調和平均)
(d) 48(取較高者較保守)
答案:(c)。各投 100 元,賺 8.33 元(100/12)和 2.08 元(100/48),合計 200 元賺 10.42 元,P/E ≈ 19.2。算術平均 30 被高 P/E 那檔誇大了超過五成。
9. 在量化交易上的應用
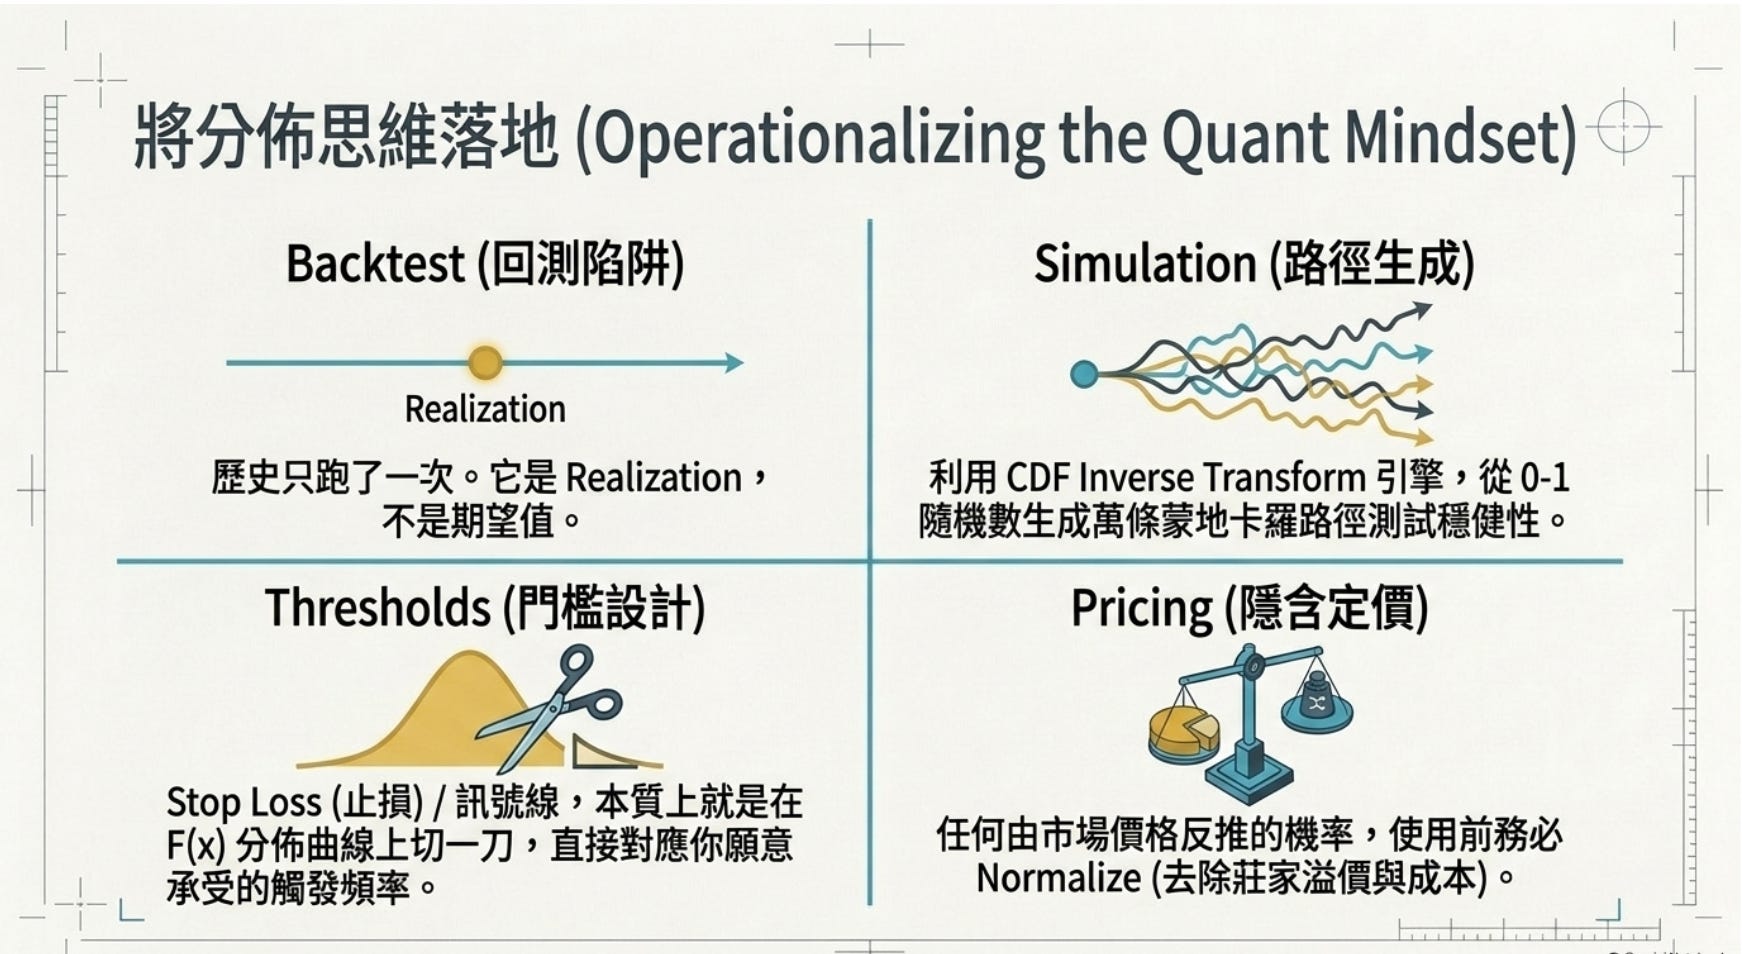
Backtest:歷史只跑了一次,回測結果是一次 realization,不是策略的機率陳述。「過去五年年化 18%」是數據點,不是期望值(expected value)。
預測:點值沒有離散度,決定不了注碼和風險;有用的形式是區間加機率。
門檻設計:stop loss(止蝕/停損)、訊號線、風險限額,都是在分佈上切一刀,
F(門檻)給出觸發頻率的下限(期內觸及的機率更高,且隨持有期上升)。市場隱含機率:由價格反推的機率加總不為 1,先 normalize 再用。
模擬:Monte Carlo 生成任意分佈的路徑,引擎是第 6 節的 inverse transform。
回報計算:時間序列用 log return,組合加權用簡單回報;見到「平均回報」先問是 arithmetic 還是 geometric。
分佈本身也是由歷史那一次抽樣估出來的,未必更準。但點值只有對錯,分佈有形狀、有頻率,可以被檢驗(testable),這是改用分佈思考的實際好處。
10. 後記
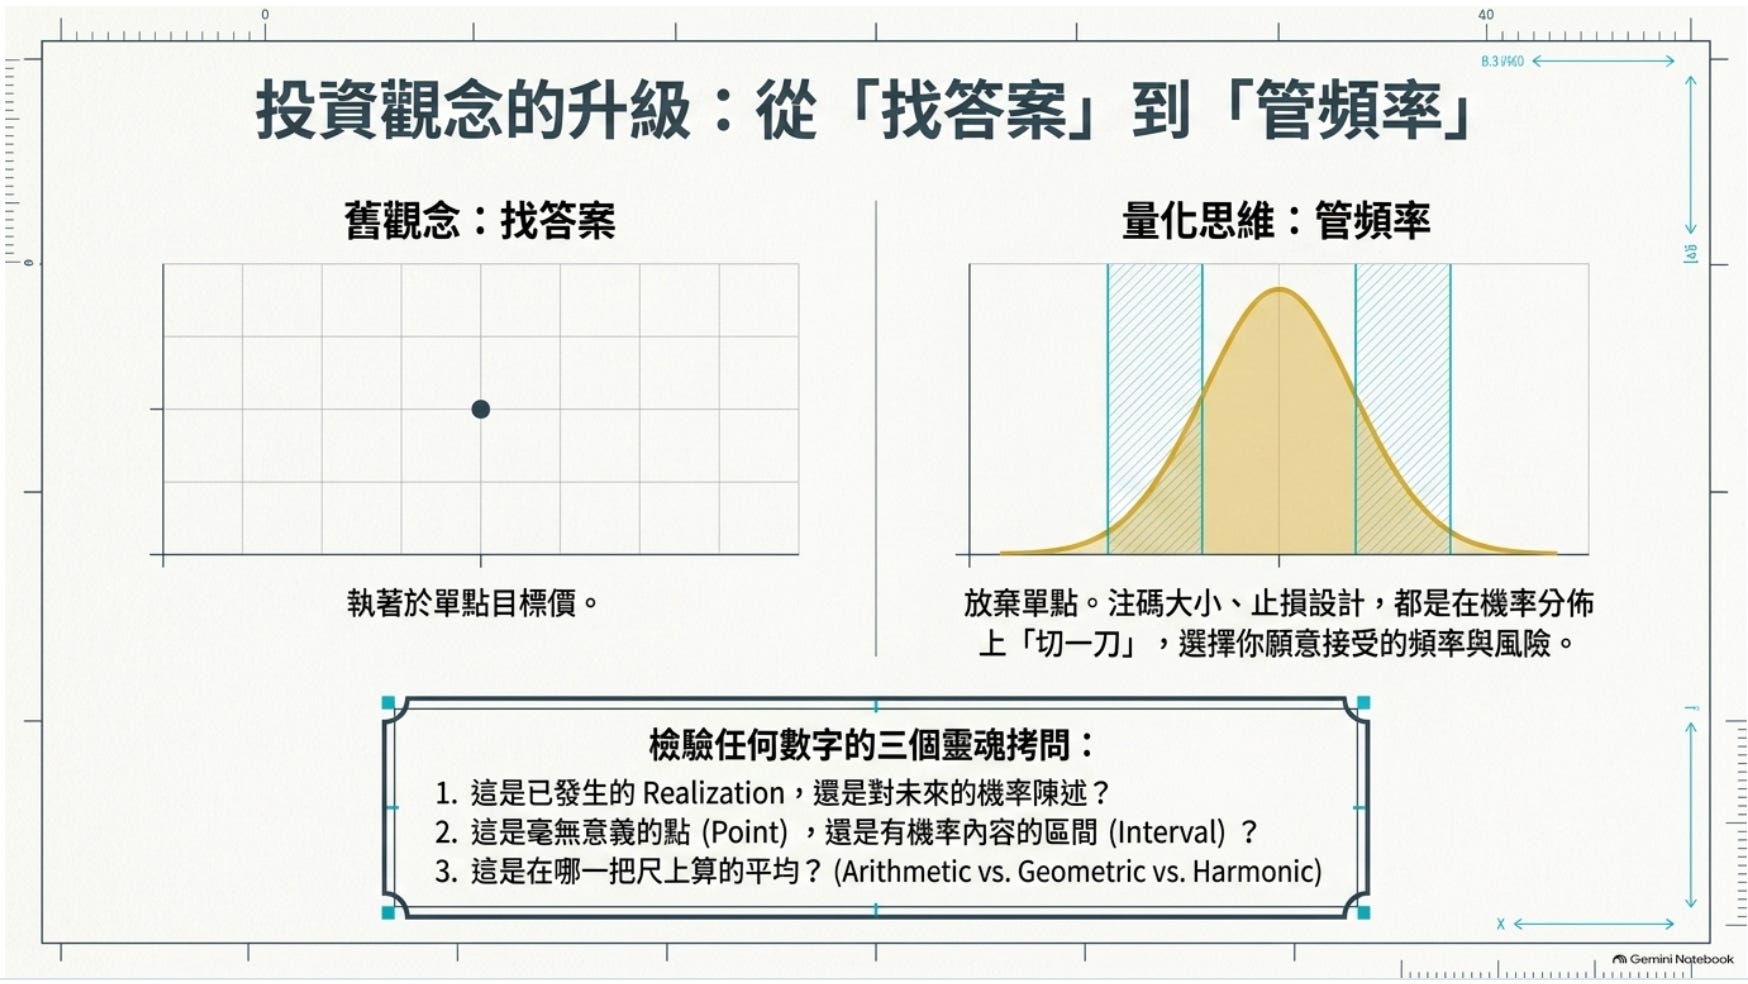
由「找答案」變成「管理頻率」。散戶問「目標價是多少」,量化思維問「落在哪個區間的機率是多少」。這樣問之後,注碼、stop loss、加碼條件變成同一類決定:在分佈上切一刀,選一個自己接受的觸發頻率,而不是逐個猜的獨立數字。
對任何單一數字先問三條:
這是 realization 還是機率陳述?
這是點還是區間?
這是在哪一把尺上算的平均?
回測年化、目標價、廣告上的「平均回報」,大部分誤導都過不了這三關。